import numpy as np                                          # 用NumPy提供同质数组、缺失值与数值函数供pandas对象运算
import pandas as pd                                         # 用pandas建立带标签的Series与DataFrame并执行索引对齐
import platform  # 识别操作系统,以便本章真实行情案例复用统一数据路径
DATA_ROOT = 'C:/qiufei/data' if platform.system() == 'Windows' else '/home/ubuntu/r2_data_mount/data' # 建立跨平台本地数据入口5 Pandas入门
5.1 引言与学习目标
学习目标
完成本章后,你应能:
- 创建带业务标签的
Series与DataFrame,并解释两个对象做算术运算时索引如何取并集和传播缺失值; - 分别使用
loc、iloc、布尔掩码和reindex完成指定行列选择,并识别链式索引风险; - 使用
apply、排序、排名和描述性统计处理题设表格,核对结果的索引、dtype 与缺失值; - 从本地长三角上市公司行情计算简单收益、样本协方差和 Pearson 相关系数,并限定描述性解释的证据边界;
- 为错位日期的等权组合明确选择完整案例、现金持有或动态再归一政策,并验证每日有效权重之和。
目标—活动—核心习题/答案映射
| 正式目标 | 正文活动 | 核心评价证据 |
|---|---|---|
| 创建带标签对象并解释自动对齐 | 小节 5.2 与 小节 5.2.1 的 Series/DataFrame 活动 | 习题 5.1—5.3 及答案中的创建、并集索引与缺失传播 |
| 使用四类选择方法并识别链式索引风险 | 小节 5.3 的索引、重建索引和链式索引活动 | 习题 5.3—5.4 及答案中的 reindex、loc、iloc 和布尔筛选 |
| 应用函数、排序、排名和描述统计 | 小节 5.3 与 小节 5.4 的成绩表活动 | 习题 5.5 及答案中的逐行统计、等级映射、排序、排名和 schema 核验 |
| 计算真实行情收益、协方差与相关 | 小节 5.4 的本地长三角公司行情活动 | 习题 5.6(a)—(e) 及答案中的收益审计、样本协方差、Pearson 相关和证据边界 |
| 为错位日期选择组合缺失政策 | 小节 5.2.1 的标签对齐机制 | 习题 5.7 及答案中的完整案例政策、固定权重与有效日期断言 |
前置知识与考核边界
读者应会使用第 2 章的字典、函数与文件路径,以及第 3 章的数组、布尔索引、均值和样本方差。本章核心评价聚焦 Pandas 数据结构、索引对齐和描述统计。回归、事件窗口、CAR 方差与因果识别仅作为章末方法阅读,不要求学生在本章实现事件研究。
pandas 是我们后续学习中的一个核心工具。它包含了强大的数据结构和数据处理工具,旨在使Python中的数据清洗和分析工作变得快速和便捷。
核心概念:量化计算在金融分析中的本质
在处理数以亿计的金融高频数据或面板数据时,传统的 Python for 循环由于其解释执行的特性,往往会成为性能瓶颈。在计算经济学中,我们倾向于使用“向量化”(Vectorization)技术。
其核心优势体现在两个层面:
- 分摊解释器开销:Python 的动态类型检查在循环执行时会产生巨大的额外负担。向量化通过一次性将整组数据传递给底层由 C 或 Fortran 编写的高性能内核,将这种开销平摊到数百万个元素上。
- 指令级并行 (SIMD):现代 CPU 具备“单指令多数据”(Single Instruction, Multiple Data)能力。Pandas 调用的底层库能够利用这些指令,在单次计算周期内处理多个浮点数,这对于计算波动率矩阵或大型投资组合的协方差具有决定性的加速作用。
在同质数值列的逐元素运算中,应优先尝试经过验证的 Pandas/NumPy 内核;但窗口递推、状态机、对象 dtype、I/O、索引对齐和用户自定义函数可能使向量化产生大量临时对象或并不占优。是否达到交互式反馈取决于算法复杂度、数据规模、内存、存储和硬件,不能由“没有显式循环”单独保证。
尽管pandas借鉴了NumPy的许多编程习惯,但两者最大的区别在于pandas是为处理表格型或异构数据而设计的。相比之下,NumPy更适合处理同质化的数值数组数据。
根据 pandas 官方项目历史,该库于 2008 年在 AQR Capital Management 开始开发,并在 2009 年底开源;2015 年起成为 NumFOCUS 赞助项目。此后它由分布式开发者社区持续维护。贡献者数量会随统计口径和日期变化,本书不使用无日期截点的动态数字衡量项目成熟度。
在本书的其余部分,我将使用以下导入约定来引入NumPy和pandas:
因此,每当你在代码中看到pd.时,它都指向pandas。由于Series和DataFrame使用得非常频繁,将它们导入到本地命名空间可能会更方便:
from pandas import Series, DataFrame # 从pandas模块导入Series, DataFrame5.2 pandas数据结构介绍
5.2.1 理论基础:数据对齐的数学原理
索引的数学定义
从数学角度,pandas的索引是标签集合到值集合的映射。
给定:
- 标签集合 \(L = \{l_1, l_2, ..., l_n\}\)
- 值集合 \(V = \{v_1, v_2, ..., v_n\}\)
- 值函数 \(f: L \to V\)
索引映射定义为: \[ \text{Index}: L \to V \] \[ l_i \mapsto v_i = f(l_i) \]
数据对齐 (Data Alignment)
给定两个 Series \(S_1:L_1\to V_1\) 与 \(S_2:L_2\to V_2\)。先把普通值域扩展为 \(V_i'=V_i\cup\{\operatorname{NaN}\}\),再把两个偏函数延拓到并集 \(L=L_1\cup L_2\):
\[ \widetilde S_i(l)= \begin{cases} S_i(l), & l\in L_i,\\ \operatorname{NaN}, & l\notin L_i. \end{cases} \tag{5.1}\]
式 式 5.1 给出本节后续实现与解释采用的数学关系。
于是,对齐结果对每一个 \(l\in L_1\cup L_2\) 都产生一行:
\[ \operatorname{Align}(S_1,S_2) =\{(l,\widetilde S_1(l),\widetilde S_2(l)):l\in L_1\cup L_2\}. \tag{5.2}\]
这一定义不会要求两侧同时已定义;若要求同时已定义,得到的将是交集对齐。pandas 的普通二元算术先按 式 5.2 取并集,再按扩展值传播规则计算,所以只在一侧出现的标签通常得到 NaN。
缺失值的数学表示
设 \(V\) 为值域(如实数集 \(\mathbb{R}\)),则扩展值域为: \[ V' = V \cup \{\text{NaN}\} \]
NaN具有以下性质:
- \(\forall x \in V: x + \text{NaN} = \text{NaN}\)
- \(\forall x \in V: x \times \text{NaN} = \text{NaN}\)
- \(\text{NaN} \neq \text{NaN}\) (NaN不等于自身)
下面用完全不相交的索引检验“并集而非交集”。结果应保留四个标签,而不是得到空索引。
left_prices = pd.Series([10.0, 11.0], index=['600276', '600104'])  # 左侧只含两只沪市公司标签
right_prices = pd.Series([20.0, 21.0], index=['002415', '002142'])  # 右侧只含两只深市公司标签
aligned_sum = left_prices + right_prices  # 普通算术在四个业务标签的并集上对齐
expected_union = left_prices.index.union(right_prices.index)  # 独立构造理论定义要求的标签并集
assert aligned_sum.index.equals(expected_union)  # 核验结果索引没有错误退化为空交集
assert aligned_sum.isna().all()  # 两侧标签完全错位,因此每个加法结果都应传播缺失值
aligned_sum  # 展示并集索引与四个NaN,作为断言的可见证据
002142 NaN
002415 NaN
600104 NaN
600276 NaN
dtype: float64要开始使用pandas,你需要熟悉它的两个核心数据结构:Series和DataFrame。虽然它们并非所有问题的通用解决方案,但它们为各种数据任务提供了坚实、灵活的基础。
5.2.2 Series
Series 是 pandas 中最基础的数据结构。你可以将它想象成一个一维的数组,但它多了一个非常关键的特性:关联索引(Labels)。在金融分析中,一个 Series 可以代表一只股票的价格序列,其中索引是日期,值是价格。
最简单的 Series 仅由一个数据数组构成:
series_data = pd.Series([4, 7, -5, 3])                      # 用列表创建一个简单的Series对象
series_data  # 展示四项数值与默认RangeIndex标签0—3的一一对应关系
0 4
1 7
2 -5
3 3
dtype: int64在交互式环境中显示的 Series 表示中,左侧是自动生成的整数索引(0 到 3),右侧是数据值及其数据类型(在这里是 int64)。由于我们没有为数据指定索引,系统会自动创建一个由 0 到 N-1 的整数组成的默认索引。你可以通过 array 和 index 属性分别获取 Series 的数组部分和索引对象:
series_data.array # 取出不含索引标签的PandasArray值容器,对比Series的两部分结构<NumpyExtensionArray>
[4, 7, -5, 3]
Length: 4, dtype: int64series_data.index # 返回默认RangeIndex及其0—3轴标签范围RangeIndex(start=0, stop=4, step=1).array属性的结果是一个PandasArray,它通常包装一个NumPy数组,但也可以包含特殊的扩展数组类型。
通常,你会希望创建一个带有索引的Series,用标签来标识每个数据点:
labeled_series = pd.Series([4, 7, -5, 3], index=['d', 'b', 'a', 'c'])  # 创建带自定义字符串索引的Series
labeled_series  # 展示d/b/a/c标签按给定顺序绑定4/7/-5/3四项值
d 4
b 7
a -5
c 3
dtype: int64labeled_series.index # 核对d/b/a/c四个业务标签按创建顺序绑定到数值轴Index(['d', 'b', 'a', 'c'], dtype='object')与NumPy数组相比,你可以在选择单个或一组值时使用索引中的标签:
labeled_series['a'] # 通过标签'a'选取对应的单个值-5labeled_series['d'] = 6 # 通过标签'd'修改对应的值为6
labeled_series[['c', 'a', 'd']] # 传入标签列表,一次选取多个值c 3
a -5
d 6
dtype: int64在这里,['c', 'a', 'd']被解释为一个索引列表,即使它包含的是字符串而不是整数。
使用NumPy函数或类似NumPy的操作,例如用布尔数组进行过滤、标量乘法或应用数学函数,都会保留索引与值之间的链接:
labeled_series[labeled_series > 0] # 用布尔条件筛选出大于0的元素d 6
b 7
c 3
dtype: int64labeled_series * 2 # 对所有元素进行标量乘法(向量化运算)d 12
b 14
a -10
c 6
dtype: int64np.exp(labeled_series) # 对每个元素计算自然指数e^xd 403.428793
b 1096.633158
a 0.006738
c 20.085537
dtype: float64另一种理解Series的方式是,可以把它看作一个固定长度的、有序的字典,因为它是索引值到数据值的映射。它可以在许多你可能使用字典的场景中使用:
'b' in labeled_series # 检查索引中是否包含标签'b'True'e' in labeled_series # 检查索引中是否包含标签'e'(不存在,返回False)False如果你有一个包含在Python字典中的数据,你可以通过传递这个字典来创建一个Series。在这里,我们用中国几个省市2020年的常住人口(单位:万人)作为例子:
sdata = {'北京': 2189, '上海': 2487, '广东': 12601, '浙江': 6456}   # 各省市2020年常住人口数据(万人)
pop_series = pd.Series(sdata)                               # 从字典创建Series,键自动成为索引
pop_series  # 展示省市字典键成为行标签、万人数值成为Series观测的映射
北京 2189
上海 2487
广东 12601
浙江 6456
dtype: int64一个Series可以通过其to_dict方法转换回字典:
pop_series.to_dict() # 将Series转换回普通Python字典{'北京': 2189, '上海': 2487, '广东': 12601, '浙江': 6456}当你只传递一个字典时,生成的Series中的索引将遵循字典keys方法的顺序,这取决于键的插入顺序。你可以通过传递一个带有你期望顺序的字典键的索引来覆盖这个默认行为:
技术细节:Python 字典顺序的一致性保障
在 Python 3.7+ 版本中,标准 dict 类型已保证了键的插入顺序。因此,在通过本地金融字典快速构建 Pandas Series 时,其索引将默认遵循键的添加顺序。但在早期版本或某些非官方 Python 构建中,字典是无序的。在金融科研领域,为了确保实验的可复现性,显式传递 index 参数指定顺序是专业量化分析师的“标准动作”。
provinces = ['浙江', '广东', '江苏', '上海']                        # 指定想要的索引顺序(包含字典中不存在的‘江苏’)
pop_series_sorted = pd.Series(sdata, index=provinces)       # 按指定索引顺序创建Series,缺失键对应NaN
pop_series_sorted  # 展示显式省市顺序,并暴露原字典缺少江苏所产生的NaN
浙江 6456.0
广东 12601.0
江苏 NaN
上海 2487.0
dtype: float64在这里,sdata中找到的三个值被放在了相应的位置,但由于没有找到'江苏'的值,它显示为NaN(Not a Number),在pandas中用来标记缺失或NA值。由于'北京'没有包含在provinces列表中,它被从结果对象中排除了。
我将交替使用“缺失(missing)”、“NA”或“空值(null)”来指代缺失数据。应使用pandas中的isna和notna函数来检测缺失数据:
核心规则:逐元素、相邻窗口与累计运算的缺失传播边界
NaN(Not a Number)在 IEEE 754 标准中被定义。对单个元素进行普通浮点算术时,只要该次运算包含 NaN,该元素的结果通常也为 NaN:
\[ x + \text{NaN} = \text{NaN}, \quad x \times \text{NaN} = \text{NaN} \]
但这条标量规则不能直接外推为“所有后续 pandas 结果都会失效”。pct_change(fill_method=None) 在第 \(t\) 行使用相邻两行 \(P_t/P_{t-1}-1\);若 \(P_t\) 缺失,则第 \(t\) 行与第 \(t+1\) 行收益缺失,但只要之后又出现一对相邻有效价格,收益就会恢复。这里的“相邻”是相邻观测行,不保证是相邻预期交易日。cumprod(skipna=True) 默认在缺失位置保留 NaN,随后却继续累乘有效项。因此真正的风险恰恰是累计路径可能静默越过未解释的缺口,而不是自动让整个序列失效。
下面的最小反例只用于核验 API 语义,不作为市场经验事实。第三个价格缺失后,第三、四个收益为缺失,第五个收益因 103 与 104 相邻而恢复;默认累计乘积也在第五行恢复:
gap_dates = pd.bdate_range('2025-01-06', periods=5)  # 构造五个连续工作日标签以暴露第三日价格缺口
gap_prices = pd.Series([100.0, 101.0, np.nan, 103.0, 104.0], index=gap_dates, name='close')  # 用指定序列复现缺失价格而非估计市场规律
gap_returns = gap_prices.pct_change(fill_method=None)  # 禁止自动填充后按相邻观测窗口计算简单收益
default_growth = (1.0 + gap_returns).cumprod(skipna=True)  # 显式采用默认跳过缺失策略,观察累计值在后续有效项恢复
strict_growth = (1.0 + gap_returns.iloc[1:]).cumprod(skipna=False)  # 排除首期结构性缺失后,让数据缺口中断余下累计路径
expected_gap_sessions = pd.bdate_range(gap_dates.min(), gap_dates.max())  # 以示例工作日日历建立应有日期集合供缺行审计
missing_session_rows = expected_gap_sessions.difference(gap_prices.index)  # 检查整行缺失,因为pct_change不会自动识别未出现的日期
missing_price_dates = gap_prices.index[gap_prices.isna()]  # 单独记录已有日期行中的价格缺失,避免与首期收益NA混淆
gap_audit = pd.DataFrame({'price': gap_prices, 'return': gap_returns, 'skipna_true': default_growth, 'skipna_false': strict_growth})  # 并列展示价格、窗口收益及两种累计政策
assert gap_prices.index.is_monotonic_increasing and gap_prices.index.is_unique  # 核验时间轴满足相邻窗口计算的基本顺序条件
assert missing_session_rows.empty and missing_price_dates.equals(gap_dates[[2]])  # 核验本反例是行内价格缺失而非日期整行消失
assert gap_returns.isna().tolist() == [True, False, True, True, False]  # 核验缺口只污染涉及该价格的两个相邻窗口
assert np.isclose(gap_returns.iloc[-1], 104.0 / 103.0 - 1.0)  # 核验随后一对有效相邻价格会恢复收益计算
assert np.isclose(default_growth.iloc[-1], 1.01 * 104.0 / 103.0)  # 核验skipna=True静默跳过缺失收益后继续复利
assert strict_growth.iloc[1:].isna().all()  # 核验skipna=False在已排除结构性首期缺失后执行严格中断政策
gap_audit # 输出反例表供读者逐行审计传播边界| price | return | skipna_true | skipna_false | |
|---|---|---|---|---|
| 2025-01-06 | 100.0 | NaN | NaN | NaN |
| 2025-01-07 | 101.0 | 0.010000 | 1.010000 | 1.01 |
| 2025-01-08 | NaN | NaN | NaN | NaN |
| 2025-01-09 | 103.0 | NaN | NaN | NaN |
| 2025-01-10 | 104.0 | 0.009709 | 1.019806 | NaN |
实际累计收益计算前应显式执行三类审计:先检查日期索引单调、唯一,并与预期交易日历比较以识别“整行消失”的日期;再区分首期无前值造成的结构性 NaN 与价格缺失造成的数据 NaN;最后记录所选政策。可选政策包括按缺口切成互不跨越的区段、保留 NA 并用 skipna=False 阻断后续累计,或在停牌、估值规则等提供明确经济依据时填补。不能依赖 cumprod 默认值替分析者作决定,也不能把未经审计的 fillna(0) 当成无收益日。
pd.isna(pop_series_sorted) # 检测每个元素是否为NaN(缺失值)浙江 False
广东 False
江苏 True
上海 False
dtype: boolpd.notna(pop_series_sorted) # 返回与原索引对齐的有效性掩码,江苏缺失项为False浙江 True
广东 True
江苏 False
上海 True
dtype: boolSeries本身也拥有这些作为实例方法:
pop_series_sorted.isna() # 检测缺失值浙江 False
广东 False
江苏 True
上海 False
dtype: bool对于许多应用来说,Series的一个有用特性是它在算术运算中会根据索引标签自动对齐:
pop_series # 展示重建索引前北京、上海、广东、浙江四个已有标签北京 2189
上海 2487
广东 12601
浙江 6456
dtype: int64pop_series_sorted # 展示重建后浙江、广东、江苏、上海顺序及江苏缺失传播浙江 6456.0
广东 12601.0
江苏 NaN
上海 2487.0
dtype: float64pop_series + pop_series_sorted # 按索引标签自动对齐后相加,不匹配的标签结果为NaN上海 4974.0
北京 NaN
广东 25202.0
江苏 NaN
浙江 12912.0
dtype: float64数据对齐的特性将在后面更详细地讨论。如果你有数据库经验,可以将其视为类似于join(连接)操作。
Series对象本身及其索引都有一个name属性,这与其他pandas功能集成在一起:
pop_series_sorted.name = 'population'  # 设置Series的名称属性为'population'
pop_series_sorted.index.name = 'province'  # 设置索引的名称属性为'province'
pop_series_sorted  # 核对值轴命名为population、标签轴命名为province
province
浙江 6456.0
广东 12601.0
江苏 NaN
上海 2487.0
Name: population, dtype: float64Series的索引可以通过赋值来原地修改:
series_data # 展示替换标签前默认0—3索引,作为就地改名的对照0 4
1 7
2 -5
3 3
dtype: int64series_data.index = ['张三', '李四', '王五', '赵六'] # 将默认整数索引替换为中文姓名索引
series_data # 核对四项值未变而轴标签已整体替换为Bob/Steve/Jeff/Ryan张三 4
李四 7
王五 -5
赵六 3
dtype: int645.2.3 DataFrame
如果说 Series 是单只股票的价格序列,那么 DataFrame 就是整个市场的行情表。它表示一个矩形的数据表格,包含一个有序的、命名的列集合,每一列都可以是不同的值类型(数值、字符串、布尔值等)。DataFrame 既有行索引也有列索引;可以把它看作是一个共享相同索引的 Series 的字典。
构建DataFrame有多种方式,但最常用的一种是从等长列表或NumPy数组组成的字典来构建。下面使用固定的省份—年份教学常量演示结构;这些数值不作为当前宏观统计,也不用于任何经验结论。后文涉及分析结论的案例会读取本地真实数据。
province_data = {'province': ['广东', '广东', '广东', '浙江', '浙江', '浙江'],  # 省份GDP数据字典:省份名称列
        'year': [2010, 2015, 2020, 2015, 2020, 2022],  # 年份列
        'gdp': [4.6, 7.3, 11.07, 4.3, 6.46, 7.77]}  # GDP值列(万亿元)
province_df = pd.DataFrame(province_data)                   # 用字典创建DataFrame,每个键成为一列
生成的 DataFrame 的索引会自动分配,就像 Series 一样,并且列会根据 data 中键的顺序来排列。在 Jupyter 或 Quarto 环境中,它会以整洁的表格形式展示:
province_df # 展示广东、浙江各三年的province/year/gdp三列面板结构| province | year | gdp | |
|---|---|---|---|
| 0 | 广东 | 2010 | 4.60 |
| 1 | 广东 | 2015 | 7.30 |
| 2 | 广东 | 2020 | 11.07 |
| 3 | 浙江 | 2015 | 4.30 |
| 4 | 浙江 | 2020 | 6.46 |
| 5 | 浙江 | 2022 | 7.77 |
可以看到,province_df 将字典的键转换为列名,并自动生成了 0 到 5 的行索引。这种结构非常适合处理面板数据(横截面 + 时间序列)。
如 图 5.1 所示,如果你正在使用Jupyter Notebook或Quarto,pandas的DataFrame对象将会以一个更适合浏览器的HTML表格形式显示。
对于大型DataFrame,head方法只选择前五行:
province_df.head() # 展示省份面板前五条记录以核对列schema与行顺序| province | year | gdp | |
|---|---|---|---|
| 0 | 广东 | 2010 | 4.60 |
| 1 | 广东 | 2015 | 7.30 |
| 2 | 广东 | 2020 | 11.07 |
| 3 | 浙江 | 2015 | 4.30 |
| 4 | 浙江 | 2020 | 6.46 |
类似地,tail返回最后五行:
province_df.tail() # 展示末五条记录,覆盖广东末期与浙江三期观测| province | year | gdp | |
|---|---|---|---|
| 1 | 广东 | 2015 | 7.30 |
| 2 | 广东 | 2020 | 11.07 |
| 3 | 浙江 | 2015 | 4.30 |
| 4 | 浙江 | 2020 | 6.46 |
| 5 | 浙江 | 2022 | 7.77 |
如果你指定一个列的序列,DataFrame的列将按照那个顺序排列:
pd.DataFrame(province_data, columns=['year', 'province', 'gdp']) # 指定列顺序为year、province、gdp| year | province | gdp | |
|---|---|---|---|
| 0 | 2010 | 广东 | 4.60 |
| 1 | 2015 | 广东 | 7.30 |
| 2 | 2020 | 广东 | 11.07 |
| 3 | 2015 | 浙江 | 4.30 |
| 4 | 2020 | 浙江 | 6.46 |
| 5 | 2022 | 浙江 | 7.77 |
如果你传递一个字典中不包含的列,它将在结果中以缺失值的形式出现:
province_df_with_debt = pd.DataFrame(province_data, columns=['year', 'province', 'gdp', 'debt'])  # 添加字典中不存在的'debt'列,自动填NaN
province_df_with_debt # 展示请求了源字典不存在的debt列后六行均为NaN| year | province | gdp | debt | |
|---|---|---|---|---|
| 0 | 2010 | 广东 | 4.60 | NaN |
| 1 | 2015 | 广东 | 7.30 | NaN |
| 2 | 2020 | 广东 | 11.07 | NaN |
| 3 | 2015 | 浙江 | 4.30 | NaN |
| 4 | 2020 | 浙江 | 6.46 | NaN |
| 5 | 2022 | 浙江 | 7.77 | NaN |
province_df_with_debt.columns # 核对显式columns参数生成year/province/gdp/debt四列Index(['year', 'province', 'gdp', 'debt'], dtype='object')DataFrame中的一列可以像字典那样通过键来检索,也可以通过点属性表示法来检索,其结果是一个Series:
province_df_with_debt['province'] # 用字典式语法取出'province'列,返回Series0 广东
1 广东
2 广东
3 浙江
4 浙江
5 浙江
Name: province, dtype: objectprovince_df_with_debt.year # 用点属性语法访问'year'列(仅限合法变量名)0 2010
1 2015
2 2020
3 2015
4 2020
5 2022
Name: year, dtype: int64属性式访问(例如 province_df_with_debt.year)和在IPython/Jupyter中对列名的Tab补全是为了方便而提供的。province_df_with_debt[column]适用于任何列名,但province_df_with_debt.column仅在列名是有效的Python变量名且不与DataFrame的任何方法名冲突时才有效。例如,如果列名包含空格或下划线以外的符号,就不能使用点属性方法访问。
行也可以通过iloc和loc这两个特殊的属性按位置或名称来检索:
province_df_with_debt.loc[1] # 用loc按标签取第1行(返回Series)year 2015
province 广东
gdp 7.3
debt NaN
Name: 1, dtype: objectprovince_df_with_debt.iloc[2] # 用iloc按位置取第3行(位置索引从0开始)year 2020
province 广东
gdp 11.07
debt NaN
Name: 2, dtype: object列可以通过赋值来修改。例如,空的debt列可以被赋一个标量值或一个值数组:
province_df_with_debt['debt'] = 16.5  # 用标量值给整列赋值,所有行都得到相同值
province_df_with_debt # 核对标量16.5已广播填入六个省份—年份行的debt列| year | province | gdp | debt | |
|---|---|---|---|---|
| 0 | 2010 | 广东 | 4.60 | 16.5 |
| 1 | 2015 | 广东 | 7.30 | 16.5 |
| 2 | 2020 | 广东 | 11.07 | 16.5 |
| 3 | 2015 | 浙江 | 4.30 | 16.5 |
| 4 | 2020 | 浙江 | 6.46 | 16.5 |
| 5 | 2022 | 浙江 | 7.77 | 16.5 |
province_df_with_debt['debt'] = np.arange(6.)  # 用等差数列[0.0, 1.0, ..., 5.0]覆盖debt列
province_df_with_debt # 核对debt列按当前行位置替换为0.0至5.0的浮点序列| year | province | gdp | debt | |
|---|---|---|---|---|
| 0 | 2010 | 广东 | 4.60 | 0.0 |
| 1 | 2015 | 广东 | 7.30 | 1.0 |
| 2 | 2020 | 广东 | 11.07 | 2.0 |
| 3 | 2015 | 浙江 | 4.30 | 3.0 |
| 4 | 2020 | 浙江 | 6.46 | 4.0 |
| 5 | 2022 | 浙江 | 7.77 | 5.0 |
当你给一列赋列表或数组时,值的长度必须与DataFrame的长度相匹配。如果你赋一个Series,它的标签将精确地与DataFrame的索引重新对齐,任何不存在的索引值处都会插入缺失值:
val = pd.Series([-1.2, -1.5, -1.7], index=[0, 2, 5])        # 创建只有3个值的Series,索引为0/2/5
province_df_with_debt['debt'] = val  # 用Series赋值,按索引对齐,不匹配的行自动填NaN
province_df_with_debt # 展示val仅在标签0/2/5命中,标签1/3/4因对齐缺值而为NaN| year | province | gdp | debt | |
|---|---|---|---|---|
| 0 | 2010 | 广东 | 4.60 | -1.2 |
| 1 | 2015 | 广东 | 7.30 | NaN |
| 2 | 2020 | 广东 | 11.07 | -1.5 |
| 3 | 2015 | 浙江 | 4.30 | NaN |
| 4 | 2020 | 浙江 | 6.46 | NaN |
| 5 | 2022 | 浙江 | 7.77 | -1.7 |
为一个不存在的列赋值将会创建一个新列。del关键字可以像删除字典键一样删除列。作为例子,我首先添加一个新列,其布尔值表示该省份是否为沿海经济发达地区:
province_df_with_debt['coastal'] = province_df_with_debt['province'].isin(['广东', '浙江'])  # 添加布尔值新列,判断省份是否属于沿海发达地区
province_df_with_debt # 核对广东、浙江行的coastal为True且缺失debt列保持原样| year | province | gdp | debt | coastal | |
|---|---|---|---|---|---|
| 0 | 2010 | 广东 | 4.60 | -1.2 | True |
| 1 | 2015 | 广东 | 7.30 | NaN | True |
| 2 | 2020 | 广东 | 11.07 | -1.5 | True |
| 3 | 2015 | 浙江 | 4.30 | NaN | True |
| 4 | 2020 | 浙江 | 6.46 | NaN | True |
| 5 | 2022 | 浙江 | 7.77 | -1.7 | True |
注意,不能使用 province_df_with_debt.coastal 这样的点属性表示法来创建新列。
然后可以使用del关键字来移除这一列:
del province_df_with_debt['coastal']                        # 用del删除'coastal'列
province_df_with_debt.columns                               # 核对删除coastal后剩余字段及其列顺序
Index(['year', 'province', 'gdp', 'debt'], dtype='object')核心挑战:视图(View)与副本(Copy)的内存逻辑
在处理如 financial_statement.h5 的千万级财务矩阵时,理解切片的底层操作至关重要。
- 视图 (View): 指向原内存块的特定偏移量。修改视图会直接改变原数据。
- 副本 (Copy): 重新分配内存并复制数据。修改副本不影响原矩阵。
严禁行为:链式索引赋值 类似 province_df_with_debt['debt'][2] = 5 的链式写法会把两次索引拆开:中间对象可能是视图,也可能是副本;赋值可能落到临时对象、触发警告,或随 Copy-on-Write 配置而改变是否影响原表。它造成的是内存别名与“赋值是否生效”的不确定性,本身不会产生前视偏差;前视偏差来自使用了决策时点尚不可得的信息,必须另行做时间边界审计。
最佳实践:使用一次 .loc 索引明确指定行列,例如 province_df_with_debt.loc[2, 'debt'] = 5。这里的“一次索引赋值”表示目标明确,不应称为并发或事务意义上的原子操作。
另一种常见的数据形式是嵌套的字典:
populations = {'广东': {2010: 10430, 2015: 10849, 2020: 12601},  # 广东各年份人口数据(万人)
'浙江': {2010: 5442, 2015: 5539, 2020: 6456}} # 浙江各年份人口数据(万人)如果将嵌套字典传递给DataFrame,pandas会将外层字典的键解释为列,内层字典的键解释为行索引:
pop_df = pd.DataFrame(populations)                          # 嵌套字典转为DataFrame,外层键为列名,内层键为行索引
pop_df # 展示年份行标签与广东/浙江两列人口序列的外层/内层字典映射| 广东 | 浙江 | |
|---|---|---|
| 2010 | 10430 | 5442 |
| 2015 | 10849 | 5539 |
| 2020 | 12601 | 6456 |
你可以使用与NumPy数组相似的语法来转置DataFrame(交换行和列):
pop_df.T # 转置操作| 2010 | 2015 | 2020 | |
|---|---|---|---|
| 广东 | 10430 | 10849 | 12601 |
| 浙江 | 5442 | 5539 | 6456 |
内层字典的键被合并起来形成结果中的索引。如果指定了显式索引,则情况不同:
pd.DataFrame(populations, index=[2015, 2020, 2025]) # 仅选取指定的三个年份行构建DataFrame| 广东 | 浙江 | |
|---|---|---|
| 2015 | 10849.0 | 5539.0 |
| 2020 | 12601.0 | 6456.0 |
| 2025 | NaN | NaN |
Series组成的字典处理方式与此非常相似:
pdata = {'广东': pop_df['广东'][:-1],                           # 取广东省除最后一年外的人口数据
         '浙江': pop_df['浙江'].iloc[:2]}  # 显式按轴位置取浙江列的前两期人口观测
pd.DataFrame(pdata) # 由长度不等的Series构建DataFrame,缺失处自动填充NaN| 广东 | 浙江 | |
|---|---|---|
| 2010 | 10430 | 5442 |
| 2015 | 10849 | 5539 |
关于可以传递给DataFrame构造函数的多种数据类型,请参见 表 5.1。
| 类型 | 说明 |
|---|---|
| 二维ndarray | 数据矩阵,可选择传入行和列的标签 |
| 数组、列表或元组的字典 | 每个序列成为DataFrame的一列;所有序列必须等长 |
| NumPy结构化/记录数组 | 被视为“数组的字典”情况 |
| Series的字典 | 每个Series成为一列;如果没有显式传递索引,则每个Series的索引被合并以形成结果的行索引 |
| 字典的字典 | 每个内层字典成为一列;键被合并以形成行索引,同“Series的字典”情况 |
| 字典或Series的列表 | 每一项成为DataFrame的一行;字典键或Series索引的并集成为DataFrame的列标签 |
| 列表的列表或元组的列表 | 被视为“二维ndarray”情况 |
| 另一个DataFrame | 除非传递了不同的索引,否则使用该DataFrame的索引 |
| NumPy掩码数组 | 类似于“二维ndarray”情况,但掩码值在DataFrame结果中为缺失值 |
如果一个DataFrame的index和columns的name属性被设置了,它们也会被显示出来:
pop_df.index.name = 'year'  # 把行轴语义标为年份,使输出中的2019—2021不被误读为普通数据列
pop_df.columns.name = 'province'  # 把列轴语义标为省份,与各人口观测值本身区分开
pop_df # 核对行轴名称year和列轴名称province已写入表结构| province | 广东 | 浙江 |
|---|---|---|
| year | ||
| 2010 | 10430 | 5442 |
| 2015 | 10849 | 5539 |
| 2020 | 12601 | 6456 |
与Series不同,DataFrame没有name属性。DataFrame的to_numpy方法返回其包含的数据,作为一个二维ndarray:
pop_df.to_numpy() # 将DataFrame转换为二维NumPy数组array([[10430, 5442],
[10849, 5539],
[12601, 6456]])如果DataFrame的列是不同的数据类型,返回数组的数据类型将会选择一个能够兼容所有列的类型:
province_df_with_debt.to_numpy() # 混合类型DataFrame转为数组,dtype自动提升为objectarray([[2010, '广东', 4.6, -1.2],
[2015, '广东', 7.3, nan],
[2020, '广东', 11.07, -1.5],
[2015, '浙江', 4.3, nan],
[2020, '浙江', 6.46, nan],
[2022, '浙江', 7.77, -1.7]], dtype=object)5.2.4 索引对象 (Index Objects)
pandas的Index对象负责持有轴标签(包括DataFrame的列名)和其他元数据(比如轴的名称)。你在构建Series或DataFrame时使用的任何数组或其他标签序列,都会在内部被转换为一个Index:
series_with_index = pd.Series(np.arange(3), index=['a', 'b', 'c'])  # 创建带字符串索引的Series(值为0,1,2)
index = series_with_index.index                             # 提取Series的Index对象
index  # 展示a/b/c三个不可变标签及其object类型Index表示
Index(['a', 'b', 'c'], dtype='object')index[1:] # 对Index对象做切片,取第2个元素起的子集Index(['b', 'c'], dtype='object')索引对象是不可变的 (immutable),因此不能被用户修改:
# 这行代码会引发TypeError
# index[1] = 'd' # 若执行会尝试原地改写不可变Index并触发TypeError不可变性使得在数据结构之间共享Index对象更加安全:
labels = pd.Index(np.arange(3))                             # 显式创建包含0,1,2的Index对象
labels  # 展示从Index切片取得的后两个标签b/c,原索引保持不变
Index([0, 1, 2], dtype='int64')series_with_int_labels = pd.Series([1.5, -2.5, 0], index=labels) # 用共享的Index对象作为索引创建Series
series_with_int_labels # 核对Series复用a/b/c标签对象并绑定1.5/-2.5/0三项值0 1.5
1 -2.5
2 0.0
dtype: float64series_with_int_labels.index is labels # 验证Series的索引与labels是同一个对象(True)True除了类似数组,Index的行为也像一个固定大小的集合:
pop_df # 展示列轴含广东、浙江两省标签,为后续成员判断提供可见基准| province | 广东 | 浙江 |
|---|---|---|
| year | ||
| 2010 | 10430 | 5442 |
| 2015 | 10849 | 5539 |
| 2020 | 12601 | 6456 |
pop_df.columns # 返回由广东、浙江构成的列Index,而非两列人口值Index(['广东', '浙江'], dtype='object', name='province')'广东' in pop_df.columns # 成员运算检验列标签而非单元格人口值,此处因存在广东列返回TrueTrue2025 in pop_df.index # 检查2025是否在行索引中False与Python的集合不同,pandas的Index可以包含重复的标签:
pd.Index(['stock_a', 'stock_a', 'stock_b', 'stock_b']) # 创建包含重复标签的Index对象Index(['stock_a', 'stock_a', 'stock_b', 'stock_b'], dtype='object')使用重复标签进行选择时,会选中该标签的所有出现。
每个Index都有许多用于集合逻辑的方法和属性,它们可以回答关于其所含数据的其他常见问题。一些有用的方法和属性总结在 表 5.2 中。
| 方法/属性 | 描述 |
|---|---|
append() |
与其他Index对象连接,生成一个新的Index |
difference() |
计算集合的差集,结果为一个Index |
intersection() |
计算集合的交集 |
union() |
计算集合的并集 |
isin() |
计算一个布尔数组,指示每个值是否包含在传入的集合中 |
delete() |
计算一个删除了位置i处元素的新Index |
drop() |
通过删除传入的值来计算一个新Index |
insert() |
通过在位置i插入元素来计算一个新Index |
is_monotonic_increasing |
如果每个元素都大于或等于前一个元素,则返回True |
is_unique |
如果Index没有重复值,则返回True |
unique() |
计算Index中唯一值的数组 |
5.3 核心功能
本节将引导你了解与Series或DataFrame中数据进行交互的基本机制。在接下来的章节中,我们将使用pandas更深入地探讨数据分析和处理的主题。
5.3.1 重建索引 (Reindexing)
pandas对象的一个重要方法是reindex,它意味着创建一个新对象,其值根据新的索引重新排列。看一个例子:
price_series = pd.Series([4.5, 7.2, -5.3, 3.6], index=['d', 'b', 'a', 'c'])  # 创建价格Series,索引顺序为d,b,a,c
price_series  # 展示d/b/a/c原始标签顺序及对应4.5/7.2/-5.3/3.6数值
d 4.5
b 7.2
a -5.3
c 3.6
dtype: float64对这个Series调用reindex会根据新的索引重新排列数据,如果某个索引值之前不存在,则引入缺失值:
reindexed_prices = price_series.reindex(['a', 'b', 'c', 'd', 'e'])  # 按a-e新索引重排,不存在的'e'填充NaN
reindexed_prices  # 展示a/b/c/d/e目标顺序,其中新增e因无来源观测为NaN
a -5.3
b 7.2
c 3.6
d 4.5
e NaN
dtype: float64对于像时间序列这样的有序数据,你可能希望在重建索引时进行一些插值或填充。method选项允许我们这样做,例如使用ffill方法,它会向前填充值:
color_series = pd.Series(['blue', 'purple', 'yellow'], index=[0, 2, 4])  # 创建颜色Series,仅在位置0,2,4有值
color_series  # 展示仅在整数标签0、2、4有颜色观测的稀疏索引结构
0 blue
2 purple
4 yellow
dtype: objectcolor_series.reindex(np.arange(6), method='ffill') # 扩展到整数标签0—5,并用最近的前一已观测颜色填补新标签0 blue
1 blue
2 purple
3 purple
4 yellow
5 yellow
dtype: object对于DataFrame,reindex可以改变行索引、列索引,或两者都改变。当只传递一个序列时,它会对结果的行进行重建索引:
region_df = pd.DataFrame(np.arange(9).reshape((3, 3)),      # 用3×3数组创建DataFrame
                     index=['a', 'c', 'd'],                 # 设置行索引为a,c,d
                     columns=['北京', '上海', '广东'])            # 设置列名为三个省市
region_df # 展示a/c/d三行与北京/上海/广东三列的重建索引基准表| 北京 | 上海 | 广东 | |
|---|---|---|---|
| a | 0 | 1 | 2 |
| c | 3 | 4 | 5 |
| d | 6 | 7 | 8 |
reindexed_region_df = region_df.reindex(index=['a', 'b', 'c', 'd'])  # 添加缺失行'b'并重新排序,'b'行填充NaN
reindexed_region_df # 展示新增标签b形成全NaN行,其余a/c/d行按原值对齐| 北京 | 上海 | 广东 | |
|---|---|---|---|
| a | 0.0 | 1.0 | 2.0 |
| b | NaN | NaN | NaN |
| c | 3.0 | 4.0 | 5.0 |
| d | 6.0 | 7.0 | 8.0 |
列可以通过columns关键字进行重建索引:
provinces = ['上海', '浙江', '广东']                              # 新的列标签序列(不含原来的'北京')
region_df.reindex(columns=provinces) # 按新列名重建索引,不存在的'浙江'填充NaN| 上海 | 浙江 | 广东 | |
|---|---|---|---|
| a | 1 | NaN | 2 |
| c | 4 | NaN | 5 |
| d | 7 | NaN | 8 |
因为'北京'不在provinces中,所以该列的数据从结果中被删除了。
你也可以使用loc操作符进行重建索引,前提是所有新的索引标签都已存在于DataFrame中。
关于reindex的参数的更多信息,请参见 表 5.3。
reindex函数参数
| 参数 | 描述 |
|---|---|
labels |
用作索引的新序列。可以是Index实例或任何其他类似序列的Python数据结构。 |
index, columns |
分别使用传入的序列作为新的行索引或列标签。 |
axis |
要重建索引的轴,'index'(行)或'columns'(列)。默认为'index'。 |
method |
插值(填充)方法;'ffill'向前填充,'bfill'向后填充。 |
fill_value |
在重建索引引入缺失数据时使用的替代值。 |
limit |
在向前或向后填充时,要填充的最大间隙大小(以元素数量计)。 |
tolerance |
在向前或向后填充时,对于非精确匹配要填充的最大间隙大小(以绝对数值距离计)。 |
level |
在MultiIndex的指定层级上匹配简单索引;否则选择子集。 |
copy |
如果为True,即使新索引与旧索引相同,也总是复制底层数据;如果为False,当索引相同时不复制数据。 |
5.3.2 删除指定轴上的条目 (Dropping Entries from an Axis)
如果你已经有一个不包含那些条目的索引数组或列表,那么从一个轴上删除一个或多个条目就很简单。drop方法将返回一个新对象,其中指定的值已从一个轴上被删除:
series_obj = pd.Series(np.arange(5.), index=['a', 'b', 'c', 'd', 'e'])  # 创建包含5个浮点数的Series(索引a-e)
series_obj  # 展示a—e五个标签与0.0—4.0值,为drop删除标签建立基准
a 0.0
b 1.0
c 2.0
d 3.0
e 4.0
dtype: float64filtered_series = series_obj.drop('c') # 删除标签'c'对应的条目
filtered_series # 核对删除c、d后仅保留a、b、e标签及对应值a 0.0
b 1.0
d 3.0
e 4.0
dtype: float64series_obj.drop(['d', 'c']) # 同时删除标签'd'和'c'的条目a 0.0
b 1.0
e 4.0
dtype: float64对于DataFrame,可以从任一轴删除索引值。为了说明这一点,我们首先创建一个示例DataFrame:
matrix_df = pd.DataFrame(np.arange(16).reshape((4, 4)),     # 用0~15的整数填充4×4矩阵形式DataFrame
                    index=['北京', '上海', '广东', '浙江'],         # 行索引为四个省份名称
                    columns=['one', 'two', 'three', 'four'])  # 列名为one到four
matrix_df # 展示北京、上海、广东、浙江行与one—four列的4×4选择基准| one | two | three | four | |
|---|---|---|---|---|
| 北京 | 0 | 1 | 2 | 3 |
| 上海 | 4 | 5 | 6 | 7 |
| 广东 | 8 | 9 | 10 | 11 |
| 浙江 | 12 | 13 | 14 | 15 |
用一个标签序列调用drop将从行标签(轴0)中删除值:
matrix_df.drop(index=['上海', '北京']) # 删除行标签为'上海'和'北京'的行| one | two | three | four | |
|---|---|---|---|---|
| 广东 | 8 | 9 | 10 | 11 |
| 浙江 | 12 | 13 | 14 | 15 |
要从列中删除标签,可以使用columns关键字:
matrix_df.drop(columns=['two']) # 删除列名为'two'的列| one | three | four | |
|---|---|---|---|
| 北京 | 0 | 2 | 3 |
| 上海 | 4 | 6 | 7 |
| 广东 | 8 | 10 | 11 |
| 浙江 | 12 | 14 | 15 |
你也可以通过传递axis=1或axis='columns'来从列中删除值:
matrix_df.drop('two', axis=1) # 通过axis=1指定删除列方向的'two'| one | three | four | |
|---|---|---|---|
| 北京 | 0 | 2 | 3 |
| 上海 | 4 | 6 | 7 |
| 广东 | 8 | 10 | 11 |
| 浙江 | 12 | 14 | 15 |
matrix_df.drop(['two', 'four'], axis='columns') # 同时删除'two'和'four'两列| one | three | |
|---|---|---|
| 北京 | 0 | 2 |
| 上海 | 4 | 6 |
| 广东 | 8 | 10 |
| 浙江 | 12 | 14 |
5.3.3 索引、选择与过滤 (Indexing, Selection, and Filtering)
Series的索引(obj[...])工作方式类似于NumPy数组的索引,不同之处在于你可以使用Series的索引值而不仅仅是整数。
series_index = pd.Series(np.arange(4.), index=['a', 'b', 'c', 'd'])  # 创建带字符串索引的Series(值为0.0-3.0)
series_index  # 展示b/a/d/c标签与0—3值的非排序映射关系
a 0.0
b 1.0
c    2.0
d    3.0
dtype: float64series_index['b'] # 用标签'b'取值,返回1.01.0series_index.iloc[1] # 显式按位置取第2项,返回标签'b'对应的1.01.0series_index.iloc[2:4] # 显式按轴位置取第3、4项,避免方括号切片规则含混c 2.0
d 3.0
dtype: float64series_index[['b', 'a', 'd']] # 用标签列表同时取多个元素b 1.0
a 0.0
d 3.0
dtype: float64series_index.iloc[[1, 3]] # 用位置列表同时取第2和第4个元素b 1.0
d 3.0
dtype: float64series_index[series_index < 2] # 用布尔索引筛选值小于2的元素a 0.0
b 1.0
dtype: float64虽然你可以通过标签来选择数据,但选择索引值的首选方法是使用特殊的loc操作符:
series_index.loc[['b', 'a', 'd']] # 用loc按标签列表取多个元素b 1.0
a 0.0
d 3.0
dtype: float64决策依据:整数索引的歧义性与标准化消除方案
对于初学者,整数索引是引发 Bug 的重灾区。Pandas 对此提供了严谨的区分:
- 属性
.loc: 解析为语义标签。如果索引是 2, 0, 1,那么loc[0]寻找标签为 0 的那一行。 - 属性
.iloc: 解析为对象当前轴上的整数位置。无论标签是什么,iloc[0]都返回轴顺序中的第一项;这描述的是逻辑轴位置,不承诺该行在底层内存中连续或处于某个物理地址。
在金融数据管道(Pipeline)中,这种区分至关重要。例如,当你在处理某省份的年份序列时,2020 既是标签(年份)也可能是位置偏移(如果数据正好有两千多行)。 最佳实践:避免用含混的 [] 表达行选择;按业务标签选择时使用 .loc,按当前轴顺序选择时使用 .iloc。这既明确分析意图,也不依赖随版本演进的回退规则。
例如,考虑一个带有整数索引的Series:
yield_series = pd.Series([1, 2, 3], index=[2, 0, 1])        # 创建整数索引的Series(索引为2,0,1)
stock_series = pd.Series([1, 2, 3], index=['a', 'b', 'c'])  # 创建字符串索引的Series(索引为a,b,c)
yield_series  # 展示标签顺序2/0/1,说明整数标签值不同于轴位置顺序
2 1
0 2
1 3
dtype: int64stock_series # 展示a/b/c字符串标签,与整数标签Series形成索引语义对照a 1
b 2
c 3
dtype: int64在yield_series上使用[]索引将使用标签,而不是位置:
yield_series[[0, 1, 2]] # 用[]索引整数索引Series时,解释为标签而非位置0 2
1 3
2 1
dtype: int64在stock_series上使用loc和整数会失败,因为它的索引不是基于整数的:
# 标签'e'不在当前Series索引中,直接访问会触发KeyError
# stock_series.loc[[0, 1]] # 字符串索引不存在整数标签0和1,执行会触发KeyError由于loc操作符完全按标签索引,因此还有一个iloc操作符,它完全按整数索引,无论索引是否包含整数,其工作方式都保持一致:
yield_series.iloc[[0, 1, 2]] # 用iloc按当前轴位置取前三项,与整数标签取值无关2 1
0 2
1 3
dtype: int64stock_series.iloc[[0, 1, 2]] # iloc对字符串索引的Series同样按位置取值a 1
b    2
c    3
dtype: int64你也可以使用loc进行标签切片,但它的工作方式与普通的Python切片不同,即终点是包含在内的:
stock_series.loc['b':'c'] # loc标签切片是两端包含的,含'b'和'c'b 2
c 3
dtype: int64使用这些方法赋值会修改Series的相应部分:
stock_series.loc['b':'c'] = 5                               # 用loc切片赋值,将'b'和'c'对应的值都改为5
stock_series  # 核对标签b至c的闭区间赋值后两项均为5,标签a保持1
a 1
b 5
c 5
dtype: int64对DataFrame进行索引会检索一个或多个列,可以使用单个值或序列:
matrix_df = pd.DataFrame(np.arange(16).reshape((4, 4)),     # 重新创建4×4的DataFrame供后续演示
                    index=['北京', '上海', '广东', '浙江'],         # 行标签按北京、上海、广东、浙江的展示顺序绑定
                    columns=['one', 'two', 'three', 'four'])  # 四个业务列标签与每行四个整数位置一一对应
matrix_df # 展示省市行键、one—four列键与0—15位置值的完整映射| one | two | three | four | |
|---|---|---|---|---|
| 北京 | 0 | 1 | 2 | 3 |
| 上海 | 4 | 5 | 6 | 7 |
| 广东 | 8 | 9 | 10 | 11 |
| 浙江 | 12 | 13 | 14 | 15 |
matrix_df['two'] # 用列名取出单列,返回Series北京 1
上海 5
广东 9
浙江 13
Name: two, dtype: int64matrix_df[['three', 'one']] # 用列名列表同时取出多列,返回DataFrame| three | one | |
|---|---|---|
| 北京 | 2 | 0 |
| 上海 | 6 | 4 |
| 广东 | 10 | 8 |
| 浙江 | 14 | 12 |
这样的索引有几个特殊情况。第一种是切片或用布尔数组选择数据:
matrix_df.iloc[:2] # 显式按轴位置取前两行,即当前顺序中的北京和上海| one | two | three | four | |
|---|---|---|---|---|
| 北京 | 0 | 1 | 2 | 3 |
| 上海 | 4 | 5 | 6 | 7 |
matrix_df[matrix_df['three'] > 5] # 用布尔条件筛选three列大于5的行| one | two | three | four | |
|---|---|---|---|---|
| 上海 | 4 | 5 | 6 | 7 |
| 广东 | 8 | 9 | 10 | 11 |
| 浙江 | 12 | 13 | 14 | 15 |
行切片写成 matrix_df.iloc[:2] 可以直接表达“按当前轴顺序取前两行”。将单个标签或标签列表传递给 [] 操作符则是选择列;本书后续统一使用 loc/iloc 表达行选择,以免混淆两套规则。
另一个用例是使用布尔DataFrame进行索引,例如由标量比较产生的DataFrame:
matrix_df < 5 # 对每个元素与5比较,生成布尔值DataFrame| one | two | three | four | |
|---|---|---|---|---|
| 北京 | True | True | True | True |
| 上海 | True | False | False | False |
| 广东 | False | False | False | False |
| 浙江 | False | False | False | False |
我们可以使用这个DataFrame将值为True的每个位置都赋为0:
matrix_df[matrix_df < 5] = 0 # 将布尔DataFrame为True的位置(值<5)赋为0
matrix_df # 核对小于5的五个单元格已按布尔DataFrame掩码替换为0| one | two | three | four | |
|---|---|---|---|---|
| 北京 | 0 | 0 | 0 | 0 |
| 上海 | 0 | 5 | 6 | 7 |
| 广东 | 8 | 9 | 10 | 11 |
| 浙江 | 12 | 13 | 14 | 15 |
5.3.3.1 使用loc和iloc在DataFrame上进行选择
与Series一样,DataFrame也具有用于基于标签和基于整数索引的特殊属性loc和iloc。作为第一个例子,让我们按标签选择单行:
matrix_df.loc['上海'] # 用loc按标签取出'上海'行,返回Seriesone 0
two 5
three 6
four 7
Name: 上海, dtype: int64要选择多行,传递一个标签序列:
matrix_df.loc[['上海', '浙江']] # 用loc按标签列表取出多行| one | two | three | four | |
|---|---|---|---|---|
| 上海 | 0 | 5 | 6 | 7 |
| 浙江 | 12 | 13 | 14 | 15 |
你可以在loc中组合行和列的选择,用逗号分隔:
matrix_df.loc['上海', ['two', 'three']] # 按上海行键与two/three列键取得两个标量值two 5
three 6
Name: 上海, dtype: int64接下来我们用iloc进行一些类似的整数选择:
matrix_df.iloc[2] # 用iloc按位置取第3行(广东)one 8
two 9
three 10
four 11
Name: 广东, dtype: int64matrix_df.iloc[[2, 1]] # 用iloc取第3和第2行| one | two | three | four | |
|---|---|---|---|---|
| 广东 | 8 | 9 | 10 | 11 |
| 上海 | 0 | 5 | 6 | 7 |
matrix_df.iloc[2, [3, 0, 1]] # 用iloc取第3行的第4,1,2列four 11
one 8
two 9
Name: 广东, dtype: int64matrix_df.iloc[[1, 2], [3, 0, 1]] # 用iloc同时指定行和列的位置| four | one | two | |
|---|---|---|---|
| 上海 | 7 | 0 | 5 |
| 广东 | 11 | 8 | 9 |
两个索引函数都支持切片,以及单个标签或标签列表:
matrix_df.loc[:'广东', 'two'] # loc标签切片:行从开头到'广东'(含),列取'two'北京 0
上海 5
广东 9
Name: two, dtype: int64matrix_df.loc[matrix_df['three'] > 5, matrix_df.columns[:3]] # 一次loc按three阈值取命中行,并保留轴位置前3列| one | two | three | |
|---|---|---|---|
| 上海 | 0 | 5 | 6 |
| 广东 | 8 | 9 | 10 |
| 浙江 | 12 | 13 | 14 |
布尔数组可以与loc一起使用,但不能与iloc一起使用:
matrix_df.loc[matrix_df.three >= 2] # 用loc配合布尔条件筛选three>=2的行| one | two | three | four | |
|---|---|---|---|---|
| 上海 | 0 | 5 | 6 | 7 |
| 广东 | 8 | 9 | 10 | 11 |
| 浙江 | 12 | 13 | 14 | 15 |
表 5.4 提供了DataFrame索引选项的简短摘要。
| 类型 | 说明 |
|---|---|
df[column] |
从DataFrame中选择单列或列序列;特殊便利用法:布尔数组(过滤行)、切片(切片行)或布尔DataFrame(基于某些标准设置值) |
df.loc[rows] |
按标签从DataFrame中选择单行或行子集 |
df.loc[:, cols] |
按标签选择单列或列子集 |
df.loc[rows, cols] |
按标签同时选择行和列 |
df.iloc[rows] |
按整数位置从DataFrame中选择单行或行子集 |
df.iloc[:, cols] |
按整数位置选择单列或列子集 |
df.iloc[rows, cols] |
按整数位置同时选择行和列 |
df.at[row, col] |
按行和列标签选择单个标量值 |
df.iat[row, col] |
按行和列位置(整数)选择单个标量值 |
reindex 方法 |
按标签选择行或列 |
5.3.3.2 整数索引的陷阱
处理由整数索引的pandas对象可能会成为一个障碍。例如,你可能不会预料到以下代码会产生错误:
ser = pd.Series(np.arange(3.)) # 创建默认整数索引(0,1,2)的Series
ser # 展示默认整数标签0/1/2,为标签-1不存在的示例建立前提0 0.0
1 1.0
2 2.0
dtype: float64# -1被解释为缺失的标签而非末项位置,因此该表达式会触发KeyError
# ser[-1] # 默认整数索引把-1解释为标签而非末项位置,执行会触发KeyError这里索引标签只包含 0、1、2,因而 ser[-1] 被解释为查找标签 -1 并触发 KeyError。不应让同一个整数在不同索引类型下时而表示标签、时而表示位置。
非整数索引也不应依赖历史上的整数位置回退;该写法已弃用并会产生 FutureWarning。位置选择应始终显式使用 iloc:
ser2 = pd.Series(np.arange(3.), index=['a', 'b', 'c']) # 创建带字符串索引的Series
ser2.iloc[-1] # 按当前轴位置明确取字符串标签Series的最后一项2.0如果你的轴索引包含整数,数据选择将始终是面向标签的。如前所述,如果你使用loc(用于标签)或iloc(用于整数),你将得到你想要的结果:
ser.iloc[-1] # 用iloc按位置取最后一个元素,避免歧义2.0同理,若意图是取得轴顺序中的前两项,应显式写出位置索引器:
ser.iloc[:2] # 按轴位置取前两项,避免把方括号切片误解为标签规则0 0.0
1 1.0
dtype: float645.3.3.3 链式索引的陷阱
这些索引属性也可以用来原地修改DataFrame对象,但这需要一些小心。
matrix_df.loc[:, 'one'] = 1 # 用loc将'one'列所有值设为1
matrix_df # 核对one列四个省市标签对应的值均已改为1| one | two | three | four | |
|---|---|---|---|---|
| 北京 | 1 | 0 | 0 | 0 |
| 上海 | 1 | 5 | 6 | 7 |
| 广东 | 1 | 9 | 10 | 11 |
| 浙江 | 1 | 13 | 14 | 15 |
matrix_df.iloc[2] = 5 # 用iloc将第3行所有值设为5
matrix_df # 核对轴位置2(广东行)的四列值均已改为5| one | two | three | four | |
|---|---|---|---|---|
| 北京 | 1 | 0 | 0 | 0 |
| 上海 | 1 | 5 | 6 | 7 |
| 广东 | 5 | 5 | 5 | 5 |
| 浙江 | 1 | 13 | 14 | 15 |
matrix_df.loc[matrix_df['four'] > 5] = 3 # 用loc配合布尔条件将four>5的行所有值设为3
matrix_df # 核对four列大于5的命中行已整行赋值为3| one | two | three | four | |
|---|---|---|---|---|
| 北京 | 1 | 0 | 0 | 0 |
| 上海 | 3 | 3 | 3 | 3 |
| 广东 | 5 | 5 | 5 | 5 |
| 浙江 | 3 | 3 | 3 | 3 |
pandas新手常犯的一个错误是在赋值时使用链式选择,像这样:data.loc[data.three == 5]['three'] = 6。
这可能会打印一个特殊的SettingWithCopyWarning警告,并且可能不会按预期工作。表达式data.loc[data.three == 5]可能返回一个视图或一个副本,所以你是在给一个临时对象赋值。解决方法是重写链式赋值,使用单个loc操作:
matrix_df.loc[matrix_df.three == 5, 'three'] = 6 # 用单个loc操作实现条件赋值,避免链式索引陷阱
matrix_df # 核对three等于5的目标单元格已在原表中更新为6| one | two | three | four | |
|---|---|---|---|---|
| 北京 | 1 | 0 | 0 | 0 |
| 上海 | 3 | 3 | 3 | 3 |
| 广东 | 5 | 5 | 6 | 5 |
| 浙江 | 3 | 3 | 3 | 3 |
5.3.4 算术与数据对齐
当你将对象相加时,如果任何索引对不相同,结果中的相应索引将是索引对的并集。
vol_series1 = pd.Series([7.3, -2.5, 3.4, 1.5], index=['a', 'c', 'd', 'e']) # 含4个元素,索引为a/c/d/e
vol_series2 = pd.Series([-2.1, 3.6, -1.5, 4, 3.1], index=['a', 'c', 'e', 'f', 'g']) # 含5个元素,索引为a/c/e/f/g,与vol_series1部分重叠
vol_series1 # 展示左序列a/c/d/e标签,为并集对齐后的缺失来源建立基准a 7.3
c -2.5
d 3.4
e 1.5
dtype: float64vol_series2 # 展示右序列a/c/e/f/g标签,明确d仅在左侧、f/g仅在右侧a -2.1
c 3.6
e -1.5
f 4.0
g 3.1
dtype: float64vol_series1 + vol_series2 # 对两个Series按索引自动对齐后逐元素相加,不重叠标签产生NaNa 5.2
c 1.1
d NaN
e 0.0
f NaN
g NaN
dtype: float64内部数据对齐在不重叠的标签位置引入了缺失值。缺失值随后会在进一步的算术计算中传播。
对于DataFrame,对齐是在行和列上都进行的:
df_a = pd.DataFrame(np.arange(9.).reshape((3, 3)), columns=list('bcd'), # 用3×3数组创建DataFrame,列名为b/c/d
index=['北京', '上海', '广东']) # 行索引设为三个省市
df_b = pd.DataFrame(np.arange(12.).reshape((4, 3)), columns=list('bde'), # 用4×3数组创建DataFrame,列名为b/d/e
index=['浙江', '北京', '上海', '江苏']) # 行索引设为四个省市
df_a # 展示0/1/2三行与b/c/d三列,标出二维对齐的左侧标签集合| b | c | d | |
|---|---|---|---|
| 北京 | 0.0 | 1.0 | 2.0 |
| 上海 | 3.0 | 4.0 | 5.0 |
| 广东 | 6.0 | 7.0 | 8.0 |
df_b # 展示0—3四行与b/d/e三列,明确共享列b/d及新增列e| b | d | e | |
|---|---|---|---|
| 浙江 | 0.0 | 1.0 | 2.0 |
| 北京 | 3.0 | 4.0 | 5.0 |
| 上海 | 6.0 | 7.0 | 8.0 |
| 江苏 | 9.0 | 10.0 | 11.0 |
将它们相加返回一个DataFrame,其索引和列是每个DataFrame中索引和列的并集:
df_a + df_b # 按行列自动对齐后相加,仅重叠位置有数值,其余为NaN| b | c | d | e | |
|---|---|---|---|---|
| 上海 | 9.0 | NaN | 12.0 | NaN |
| 北京 | 3.0 | NaN | 6.0 | NaN |
| 广东 | NaN | NaN | NaN | NaN |
| 江苏 | NaN | NaN | NaN | NaN |
| 浙江 | NaN | NaN | NaN | NaN |
如果你将没有共同列或行标签的DataFrame对象相加,结果将全部是空值。
5.3.4.1 带有填充值的算术方法
在不同索引对象之间的算术运算中,你可能希望当一个轴标签在一个对象中找到而另一个对象中没有时,用一个特殊值(如0)来填充。
df_a = pd.DataFrame(np.arange(12.).reshape((3, 4)), columns=list('abcd')) # 用3×4数组创建DataFrame,列名a/b/c/d
df_b = pd.DataFrame(np.arange(20.).reshape((4, 5)), columns=list('abcde')) # 用4×5数组创建DataFrame,列名a/b/c/d/e
df_b.loc[1, 'b'] = np.nan # 人为制造双方共有位置的缺失,以区分原生NaN与标签并集产生的NaN
df_a # 展示填充值算术左表的0—2行与a—d四列| a | b | c | d | |
|---|---|---|---|---|
| 0 | 0.0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | 6.0 | 7.0 |
| 2 | 8.0 | 9.0 | 10.0 | 11.0 |
df_b # 展示右表新增行3和列e,定位除法对齐产生NaN的位置| a | b | c | d | e | |
|---|---|---|---|---|---|
| 0 | 0.0 | 1.0 | 2.0 | 3.0 | 4.0 |
| 1 | 5.0 | NaN | 7.0 | 8.0 | 9.0 |
| 2 | 10.0 | 11.0 | 12.0 | 13.0 | 14.0 |
| 3 | 15.0 | 16.0 | 17.0 | 18.0 | 19.0 |
将它们相加会导致在不重叠的位置出现缺失值:
df_a + df_b # 直接相加:不重叠的行列位置及原有NaN位置均变为NaN| a | b | c | d | e | |
|---|---|---|---|---|---|
| 0 | 0.0 | 2.0 | 4.0 | 6.0 | NaN |
| 1 | 9.0 | NaN | 13.0 | 15.0 | NaN |
| 2 | 18.0 | 20.0 | 22.0 | 24.0 | NaN |
| 3 | NaN | NaN | NaN | NaN | NaN |
使用df_a的add方法,我们传递df_b和一个fill_value参数:
df_a.add(df_b, fill_value=0) # 用add方法相加,缺失值先填0再计算,避免NaN传播| a | b | c | d | e | |
|---|---|---|---|---|---|
| 0 | 0.0 | 2.0 | 4.0 | 6.0 | 4.0 |
| 1 | 9.0 | 5.0 | 13.0 | 15.0 | 9.0 |
| 2 | 18.0 | 20.0 | 22.0 | 24.0 | 14.0 |
| 3 | 15.0 | 16.0 | 17.0 | 18.0 | 19.0 |
表 5.5 列出了Series和DataFrame的算术方法。每个方法都有一个以字母r开头的对应方法,其参数是反转的。
1 / df_a # 标量1除以df_a的每个元素(等价于df_a.rdiv(1))| a | b | c | d | |
|---|---|---|---|---|
| 0 | inf | 1.000000 | 0.500000 | 0.333333 |
| 1 | 0.250 | 0.200000 | 0.166667 | 0.142857 |
| 2 | 0.125 | 0.111111 | 0.100000 | 0.090909 |
df_a.rdiv(1) # 反向除法:等价于1/df_a,用方法形式支持额外参数| a | b | c | d | |
|---|---|---|---|---|
| 0 | inf | 1.000000 | 0.500000 | 0.333333 |
| 1 | 0.250 | 0.200000 | 0.166667 | 0.142857 |
| 2 | 0.125 | 0.111111 | 0.100000 | 0.090909 |
相关地,在对Series或DataFrame进行重建索引时,你也可以指定一个不同的填充值:
df_a.reindex(columns=df_b.columns, fill_value=0) # 将df_a的列扩展至df_b的列集合,新增列填0| a | b | c | d | e | |
|---|---|---|---|---|---|
| 0 | 0.0 | 1.0 | 2.0 | 3.0 | 0 |
| 1 | 4.0 | 5.0 | 6.0 | 7.0 | 0 |
| 2 | 8.0 | 9.0 | 10.0 | 11.0 | 0 |
| 方法 | 描述 |
|---|---|
add, radd |
加法 (+) 的方法 |
sub, rsub |
减法 (-) 的方法 |
div, rdiv |
除法 (/) 的方法 |
floordiv, rfloordiv |
整除 (//) 的方法 |
mul, rmul |
乘法 (*) 的方法 |
pow, rpow |
幂运算 (**) 的方法 |
5.3.4.2 DataFrame与Series之间的运算
DataFrame和Series之间的算术运算也是有定义的。首先,考虑一个二维数组和它的一行之间的差异:
matrix_data = np.arange(12.).reshape((3, 4)) # 创建3×4的二维数组(值为0.0到11.0)
matrix_data # 展示3×4浮点数组,使末轴长度4与一维减数的广播关系可见array([[ 0., 1., 2., 3.],
[ 4., 5., 6., 7.],
[ 8., 9., 10., 11.]])matrix_data[0] # 取出第0行(一维数组),作为广播的减数array([0., 1., 2., 3.])matrix_data - matrix_data[0] # 每一行都减去第0行,广播沿行方向展开array([[0., 0., 0., 0.],
[4., 4., 4., 4.],
[8., 8., 8., 8.]])当我们从matrix_data中减去matrix_data[0]时,这个减法操作会对每一行都执行一次。这被称为广播 (broadcasting)。DataFrame和Series之间的运算是相似的。
核心机制:广播(Broadcasting)的维度匹配逻辑
广播是 Pandas 能够处理多资产异构计算的关键。其底层遵循维度对齐原则:
- 逐维兼容:从后向前比较,维度必须相等或其中一个为 1。
- 自动扩展:形状为
(n,)的Series会被拉伸至匹配DataFrame的(m, n)。
在量化金融中,这种机制常用于:
- 去均值化: 从价格矩阵减去均值向量。
- 权重分配: 将权重向量广播至全样本时间序列。
通过显式指定 axis='index' (或 0),你可以将横向(列)对齐切换为纵向(行)对齐。这在计算单个资产对全市场的对冲比率时非常有用。
sample_df = pd.DataFrame(np.arange(12.).reshape((4, 3)), # 用4×3数组创建DataFrame,用于演示广播运算
columns=list('bde'), # b/d/e标签定义Series与DataFrame横向对齐的键
index=['浙江', '北京', '上海', '江苏']) # 省市标签定义纵向广播时的行对齐键与展示顺序
row_series = sample_df.iloc[0] # 用iloc取出第0行(浙江)作为Series
sample_df # 展示四省市行与b/d/e列,确认默认Series算术按列标签对齐| b | d | e | |
|---|---|---|---|
| 浙江 | 0.0 | 1.0 | 2.0 |
| 北京 | 3.0 | 4.0 | 5.0 |
| 上海 | 6.0 | 7.0 | 8.0 |
| 江苏 | 9.0 | 10.0 | 11.0 |
row_series # 展示浙江行转成以b/d/e为索引的一维减数b 0.0
d 1.0
e 2.0
Name: 浙江, dtype: float64默认情况下,DataFrame和Series之间的算术运算会将Series的索引与DataFrame的列进行匹配,并向下广播行:
sample_df - row_series # 每一行都减去row_series(第0行),按列名对齐后广播| b | d | e | |
|---|---|---|---|
| 浙江 | 0.0 | 0.0 | 0.0 |
| 北京 | 3.0 | 3.0 | 3.0 |
| 上海 | 6.0 | 6.0 | 6.0 |
| 江苏 | 9.0 | 9.0 | 9.0 |
如果在DataFrame的列或Series的索引中找不到某个索引值,对象将被重新索引以形成并集:
new_index_series = pd.Series(np.arange(3), index=['b', 'e', 'f']) # 创建索引含f的Series,与sample_df列不完全匹配
sample_df + new_index_series # 按列名对齐相加:d列和f列因无匹配变为NaN| b | d | e | f | |
|---|---|---|---|---|
| 浙江 | 0.0 | NaN | 3.0 | NaN |
| 北京 | 3.0 | NaN | 6.0 | NaN |
| 上海 | 6.0 | NaN | 9.0 | NaN |
| 江苏 | 9.0 | NaN | 12.0 | NaN |
如果你想在列上进行广播,匹配行,你必须使用其中一个算术方法并指定在索引上匹配(axis='index'):
col_series = sample_df['d'] # 取出d列作为Series,索引为行标签(省市名)
sample_df # 重示四省市×三列原表,供按行标签广播的结果对照| b | d | e | |
|---|---|---|---|
| 浙江 | 0.0 | 1.0 | 2.0 |
| 北京 | 3.0 | 4.0 | 5.0 |
| 上海 | 6.0 | 7.0 | 8.0 |
| 江苏 | 9.0 | 10.0 | 11.0 |
col_series # 展示d列以省市为索引,作为axis='index'逐行减数浙江 1.0
北京 4.0
上海 7.0
江苏 10.0
Name: d, dtype: float64sample_df.sub(col_series, axis='index') # 沿行方向广播:每列都减去d列对应行的值| b | d | e | |
|---|---|---|---|
| 浙江 | -1.0 | 0.0 | 1.0 |
| 北京 | -1.0 | 0.0 | 1.0 |
| 上海 | -1.0 | 0.0 | 1.0 |
| 江苏 | -1.0 | 0.0 | 1.0 |
5.3.5 函数应用和映射 (Function Application and Mapping)
NumPy的通用函数(ufuncs,即逐元素的数组方法)也适用于pandas对象:
apply_example_rng = np.random.default_rng(seed=20240501) # 为apply示例建立不受其他单元影响的局部固定随机流
random_df = pd.DataFrame(apply_example_rng.standard_normal((4, 3)), # 用可复现的4×3标准正态样本创建DataFrame
columns=list('bde'), # 三个列标签用于观察apply默认逐列调用
index=['浙江', '北京', '上海', '江苏']) # 四个省市行标签用于观察axis='columns'逐行调用
random_df # 展示四省市×b/d/e随机输入,供逐列和逐行函数调用比较| b | d | e | |
|---|---|---|---|
| 浙江 | -0.326967 | -0.974315 | 0.494588 |
| 北京 | 0.424990 | -0.441219 | -0.099676 |
| 上海 | -1.803692 | -0.882380 | 0.216588 |
| 江苏 | 0.595547 | -0.008975 | -0.822750 |
np.abs(random_df) # 对四省市×三列逐元素取绝对值,同时保留原行列标签| b | d | e | |
|---|---|---|---|
| 浙江 | 0.326967 | 0.974315 | 0.494588 |
| 北京 | 0.424990 | 0.441219 | 0.099676 |
| 上海 | 1.803692 | 0.882380 | 0.216588 |
| 江苏 | 0.595547 | 0.008975 | 0.822750 |
另外一个常见的操作是将一个作用于一维数组的函数应用到每一列或每一行。DataFrame的apply方法正是为此而生:
def range_func(x): # 输入是apply沿指定轴交付的一维标签组,输出同组最大值与最小值之差
return x.max() - x.min() # 返回该轴标签组内最大值与最小值之差
random_df.apply(range_func) # 默认对b/d/e三列分别计算四省市观测的极差b 2.399240
d 0.965340
e 1.317338
dtype: float64如果你向apply传递axis='columns',函数将对每一行调用一次。
random_df.apply(range_func, axis='columns') # 对浙江、北京、上海、江苏各行分别计算三列极差浙江 1.468903
北京 0.866209
上海 2.020280
江苏 1.418298
dtype: float64传递给apply的函数不一定返回一个标量值;它也可以返回一个包含多个值的Series:
def stats_func(x): # 返回带min/max标签的两项Series,使apply结果扩展为可解释的统计行
return pd.Series([x.min(), x.max()], index=['min', 'max']) # 用min/max结果标签明确两项输出的统计语义
random_df.apply(stats_func) # 对每列生成min/max两行,保留b/d/e列schema| b | d | e | |
|---|---|---|---|
| min | -1.803692 | -0.974315 | -0.822750 |
| max | 0.595547 | -0.008975 | 0.494588 |
逐元素的Python函数也可以使用。假设你想从random_df中的每个浮点值计算一个格式化的字符串,可以使用DataFrame.map:
def format_func(x): # 把单个数值变为两位小数文本;该展示转换会丢失可继续计算的数值dtype
return f'{x:.2f}' # 返回仅用于展示的文本,不再保持数值dtype
random_df.map(format_func) # 对每个元素应用展示格式函数,结果各列转为字符串dtype| b | d | e | |
|---|---|---|---|
| 浙江 | -0.33 | -0.97 | 0.49 |
| 北京 | 0.42 | -0.44 | -0.10 |
| 上海 | -1.80 | -0.88 | 0.22 |
| 江苏 | 0.60 | -0.01 | -0.82 |
Series同样提供map方法,用于对一维对象逐元素应用函数:
random_df['e'].map(format_func) # 元素级映射变换浙江 0.49
北京 -0.10
上海 0.22
江苏 -0.82
Name: e, dtype: object5.3.6 排序和排名 (Sorting and Ranking)
要按行或列标签进行字典序排序,使用sort_index方法,它返回一个新的、已排序的对象:
series_to_sort = pd.Series(np.arange(4), index=['d', 'a', 'b', 'c']) # 创建索引乱序的Series(d=0, a=1, b=2, c=3)
series_to_sort.sort_index() # 按a、b、c、d标签升序重排行,数值仍随各自原标签移动a 1
b 2
c 3
d 0
dtype: int64对于DataFrame,你可以按任一轴的索引进行排序:
df_to_sort = pd.DataFrame(np.arange(8).reshape((2, 4)), # 用2×4数组创建DataFrame
index=['three', 'one'], # 原始标签次序three/one与字典序相反,便于观察整行随标签重排
columns=['d', 'a', 'b', 'c']) # 列名也故意乱序
df_to_sort.sort_index() # 按行索引字典序排列(one在three前)| d | a | b | c | |
|---|---|---|---|---|
| one | 4 | 5 | 6 | 7 |
| three | 0 | 1 | 2 | 3 |
df_to_sort.sort_index(axis='columns') # 按列名字典序排列(a,b,c,d)| a | b | c | d | |
|---|---|---|---|---|
| three | 1 | 2 | 3 | 0 |
| one | 5 | 6 | 7 | 4 |
数据默认按升序排序,但也可以按降序排序:
df_to_sort.sort_index(axis='columns', ascending=False) # 按列名降序排列(d,c,b,a)| d | c | b | a | |
|---|---|---|---|---|
| three | 0 | 3 | 2 | 1 |
| one | 4 | 7 | 6 | 5 |
要按值对Series进行排序,使用其sort_values方法:
series_to_sort = pd.Series([4, 7, -3, 2]) # 创建包含4个整数的Series
series_to_sort.sort_values() # 按值升序排列(-3, 2, 4, 7)2 -3
3 2
0 4
1 7
dtype: int64任何缺失值默认都会被排到Series的末尾:
series_to_sort = pd.Series([4, np.nan, 7, np.nan, -3, 2]) # 创建含有两个NaN的Series
series_to_sort.sort_values() # 按值升序排列,NaN默认排在末尾4 -3.0
5 2.0
0 4.0
2 7.0
1 NaN
3 NaN
dtype: float64通过使用na_position选项,缺失值可以被排到开头:
series_to_sort.sort_values(na_position='first') # NaN排到开头位置1 NaN
3 NaN
4 -3.0
5 2.0
0 4.0
2 7.0
dtype: float64在对DataFrame进行排序时,你可以使用一列或多列中的数据作为排序键。
df_to_sort = pd.DataFrame({'b': [4, 7, -3, 2], 'a': [0, 1, 0, 1]}) # 创建含b和a两列的DataFrame
df_to_sort # 展示b为主排序键、a为次排序键的四行原始组合| b | a | |
|---|---|---|
| 0 | 4 | 0 |
| 1 | 7 | 1 |
| 2 | -3 | 0 |
| 3 | 2 | 1 |
df_to_sort.sort_values('b') # 按b列的值升序排列| b | a | |
|---|---|---|
| 2 | -3 | 0 |
| 3 | 2 | 1 |
| 0 | 4 | 0 |
| 1 | 7 | 1 |
要按多列排序,传递一个列名的列表:
df_to_sort.sort_values(['a', 'b']) # 先按a列升序,同值内再按b列升序| b | a | |
|---|---|---|
| 2 | -3 | 0 |
| 0 | 4 | 0 |
| 3 | 2 | 1 |
| 1 | 7 | 1 |
排名(Ranking)会为数组中的有效数据点分配从1到N的排名。默认情况下,rank通过为每个组分配平均排名来处理平级关系:
series_to_sort = pd.Series([7, -5, 7, 4, 2, 0, 4]) # 创建含有平级值的Series(7和4各出现两次)
series_to_sort.rank() # 默认排名:平级取平均值(method='average')0 6.5
1 1.0
2 6.5
3 4.5
4 3.0
5 2.0
6 4.5
dtype: float64排名也可以根据它们在数据中出现的顺序来分配:
series_to_sort.rank(method='first') # 按元素出现顺序打破平级(先出现的排名靠前)0 6.0
1 1.0
2 7.0
3 4.0
4 3.0
5 2.0
6 5.0
dtype: float64你也可以按降序排名:
series_to_sort.rank(ascending=False) # 降序排名:最大值获得排名10 1.5
1 7.0
2 1.5
3 3.5
4 5.0
5 6.0
6 3.5
dtype: float64DataFrame可以在行或列上计算排名。表 5.6 列出了排名的平级处理方法。
df_to_sort = pd.DataFrame({'b': [4.3, 7, -3, 2], 'a': [0, 1, 0, 1], # 创建含3列的DataFrame
'c': [-2, 5, 8, -2.5]}) # 列c包含负值和正值
df_to_sort # 展示a/b/c三列不同量级,为axis='columns'行内排名建立输入| b | a | c | |
|---|---|---|---|
| 0 | 4.3 | 0 | -2.0 |
| 1 | 7.0 | 1 | 5.0 |
| 2 | -3.0 | 0 | 8.0 |
| 3 | 2.0 | 1 | -2.5 |
df_to_sort.rank(axis='columns') # 按行方向对每行内的值进行排名(1=最小)| b | a | c | |
|---|---|---|---|
| 0 | 3.0 | 2.0 | 1.0 |
| 1 | 3.0 | 1.0 | 2.0 |
| 2 | 1.0 | 2.0 | 3.0 |
| 3 | 3.0 | 2.0 | 1.0 |
rank的平级处理方法
| 方法 | 描述 |
|---|---|
'average' |
默认:为平级组中的每个条目分配平均排名 |
'min' |
为整个组使用最小排名 |
'max' |
为整个组使用最大排名 |
'first' |
按值在数据中出现的顺序分配排名 |
'dense' |
类似于method='min',但组与组之间的排名总是增加1 |
5.3.7 带有重复标签的轴索引 (Axis Indexes with Duplicate Labels)
虽然许多pandas函数(如reindex)要求标签是唯一的,但这并不是强制性的。
dup_series = pd.Series(np.arange(5), index=['a', 'a', 'b', 'b', 'c']) # 创建带有重复标签的Series(a和b各出现两次)
dup_series # 展示a、b标签各对应两项值,说明单标签访问可能返回Seriesa 0
a 1
b 2
b 3
c 4
dtype: int64索引的is_unique属性可以告诉你其标签是否唯一:
dup_series.index.is_unique # 检查索引是否具有唯一性(返回False)False索引一个有多个条目的标签会返回一个Series,而单个条目则返回一个标量值:
dup_series['a'] # 用重复标签'a'索引,返回含两个元素的Seriesa 0
a 1
dtype: int64dup_series['c'] # 用唯一标签'c'索引,返回单个标量值4同样的逻辑也适用于在DataFrame中索引行:
duplicate_index_rng = np.random.default_rng(seed=20240502) # 为重复索引示例建立独立固定随机流,避免依赖前文调用顺序
dup_df = pd.DataFrame(duplicate_index_rng.standard_normal((5, 3)), # 五条可复现观测用于比较唯一与重复标签的返回维度
index=['a', 'a', 'b', 'b', 'c']) # a、b各出现两次,因此loc单标签也可能返回多行表
dup_df # 展示三条a行和两条b行,明确重复标签选择的返回基数| 0 | 1 | 2 | |
|---|---|---|---|
| a | 0.458426 | 0.296724 | 0.371069 |
| a | -0.678360 | 0.742797 | 0.571959 |
| b | 0.921204 | 1.585205 | -1.035457 |
| b | -0.735429 | 1.172170 | -0.491216 |
| c | 0.113112 | 0.958800 | -0.311517 |
dup_df.loc['b'] # 用重复标签'b'索引,返回两行组成的DataFrame| 0 | 1 | 2 | |
|---|---|---|---|
| b | 0.921204 | 1.585205 | -1.035457 |
| b | -0.735429 | 1.172170 | -0.491216 |
dup_df.loc['c'] # 用唯一标签'c'索引,返回单行Series0 0.113112
1 0.958800
2 -0.311517
Name: c, dtype: float645.4 汇总与描述性统计
pandas对象配备了一套常见的数学和统计方法。这些方法大多数属于归约 (reductions) 或汇总统计 (summary statistics) 的范畴。它们内置了对缺失数据的处理。
financial_na_df = pd.DataFrame([[1.4, np.nan], [7.1, -4.5], # 创建含NaN的两列DataFrame
[np.nan, np.nan], [0.75, -1.3]], # c行全为NaN,用于演示缺失值处理
index=['a', 'b', 'c', 'd'], # 行索引为a/b/c/d
columns=['one', 'two']) # 列名为one和two
financial_na_df # 展示a/b行部分可观测、c行全缺失的两列归约输入| one | two | |
|---|---|---|
| a | 1.40 | NaN |
| b | 7.10 | -4.5 |
| c | NaN | NaN |
| d | 0.75 | -1.3 |
调用DataFrame的sum方法会返回一个包含列总和的Series:
financial_na_df.sum() # 对每列求和(默认跳过NaN)one 9.25
two -5.80
dtype: float64传递axis='columns'则会对行进行求和:
financial_na_df.sum(axis='columns') # 对每行求和(c行全NaN,结果为0.0)a 1.40
b 2.60
c 0.00
d -0.55
dtype: float64当整行或整列都包含NA值时,总和为0。这可以通过skipna选项(默认为True)来禁用,此时总和为NA:
financial_na_df.sum(axis='index', skipna=False) # 对每列求和且不跳过NaN,含NaN的列结果为NaNone NaN
two NaN
dtype: float64financial_na_df.sum(axis='columns', skipna=False) # 对每行求和且不跳过NaN,c行结果为NaNa NaN
b 2.60
c NaN
d -0.55
dtype: float64一些聚合操作,如mean,至少需要一个非NA值才能产生有效结果:
financial_na_df.mean(axis='columns') # 对每行求均值,c行全NaN结果为NaNa 1.400
b 1.300
c NaN
d -0.275
dtype: float64表 5.7 列出了归约方法的常用选项。
| 方法 | 描述 |
|---|---|
axis |
进行归约的轴;'index'表示行,'columns'表示列 |
skipna |
排除缺失值;默认为True |
pandas 2.0 已移除归约方法的 level 参数。若要按分层索引的某一级归约,应先显式分组,例如 series.groupby(level='层名').sum();这也把分组键和聚合动作分别暴露出来,便于审计。
一些方法,如idxmin和idxmax,返回的是间接统计量,比如取得最小值或最大值的索引值:
financial_na_df.idxmax() # 分列返回非缺失最大值所在行标签,并跳过c行NaNone b
two d
dtype: object其他方法是累积型的:
financial_na_df.cumsum() # 沿行轴逐列累加;缺失位置保持NaN而后续观测继续累计| one | two | |
|---|---|---|
| a | 1.40 | NaN |
| b | 8.50 | -4.5 |
| c | NaN | NaN |
| d | 9.25 | -5.8 |
describe就是这样一个例子,它能一次性产生多个汇总统计量:
financial_na_df.describe() # 汇总各数值列非缺失计数、分位数与离散程度| one | two | |
|---|---|---|
| count | 3.000000 | 2.000000 |
| mean | 3.083333 | -2.900000 |
| std | 3.493685 | 2.262742 |
| min | 0.750000 | -4.500000 |
| 25% | 1.075000 | -3.700000 |
| 50% | 1.400000 | -2.900000 |
| 75% | 4.250000 | -2.100000 |
| max | 7.100000 | -1.300000 |
对于非数值数据,describe会产生另一种汇总统计量:
industry_cat_series = pd.Series(['IT', 'IT', 'Finance', 'Energy'] * 4) # 创建包含重复字符串的分类型Series(共16个元素)
industry_cat_series.describe() # 汇总行业类别的有效数、类别数、众数及众数频次count 16
unique 3
top IT
freq 8
dtype: object表 5.8 列出了一个完整的汇总统计和相关方法的集合。
| 方法 | 描述 |
|---|---|
count |
非NA值的数量 |
describe |
计算一组汇总统计量 |
min, max |
计算最小值和最大值 |
argmin, argmax |
计算取得最小值或最大值的索引位置(整数) |
idxmin, idxmax |
计算取得最小值或最大值的索引标签 |
quantile |
计算样本分位数,范围从0到1(默认:0.5) |
sum |
值的总和 |
mean |
值的平均值 |
median |
值的算术中位数(50%分位数) |
prod |
所有值的乘积 |
var |
样本方差 |
std |
样本标准差 |
skew |
经过标准化与偏差校正的样本偏度;不是原始三阶矩 |
kurt |
Fisher 定义的无偏超额峰度;正态分布基准为0,不是原始四阶矩 |
cumsum |
值的累积和 |
cummin, cummax |
值的累积最小值或最大值 |
cumprod |
值的累积积;默认 skipna=True 会在缺失位置显示 NA,但后续有效项继续累计 |
diff |
计算一阶算术差分(对时间序列有用) |
pct_change |
按相邻观测行计算百分比变化;fill_method=None 不自动填补窗口内缺失值 |
5.4.1 相关性与协方差 (Correlation and Covariance)
皮尔逊相关系数的数学推导
在深入实践之前,让我们从数学角度理解皮尔逊相关系数的完整推导。
给定两个随机变量 \(X\) 和 \(Y\) 的 \(n\) 个观测值:\(\{(x_1, y_1), (x_2, y_2), ..., (x_n, y_n)\}\)
样本均值: \[ \bar{X} = \frac{1}{n}\sum_{i=1}^{n} x_i, \quad \bar{Y} = \frac{1}{n}\sum_{i=1}^{n} y_i \]
样本方差: \[ \text{Var}(X) = \frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{X})^2 \] \[ \text{Var}(Y) = \frac{1}{n-1}\sum_{i=1}^{n}(y_i - \bar{Y})^2 \]
样本协方差: \[ \text{Cov}(X, Y) = \frac{1}{n-1}\sum_{i=1}^{n}(x_i - \bar{X})(y_i - \bar{Y}) \]
皮尔逊相关系数: \[ \rho_{X,Y} = \frac{\text{Cov}(X, Y)}{\sqrt{\text{Var}(X) \cdot \text{Var}(Y)}} \]
展开形式: \[ \rho_{X,Y} = \frac{\sum_{i=1}^{n}(x_i - \bar{X})(y_i - \bar{Y})}{\sqrt{\sum_{i=1}^{n}(x_i - \bar{X})^2 \cdot \sum_{i=1}^{n}(y_i - \bar{Y})^2}} \]
协方差矩阵的数学性质
对于 \(k\) 个随机向量 \(\mathbf{X} = (X_1, X_2, ..., X_k)^T\),协方差矩阵 \(\Sigma\) 定义为:
\[ \Sigma_{ij} = \text{Cov}(X_i, X_j) = E[(X_i - E[X_i])(X_j - E[X_j])] \]
协方差矩阵具有以下重要性质:
- 对称性:\(\Sigma = \Sigma^T\)
- 半正定性:对于任意向量 \(\mathbf{w}\),\(\mathbf{w}^T \Sigma \mathbf{w} \geq 0\)
- 对角元素:\(\Sigma_{ii} = \text{Var}(X_i)\)
现在让我们使用来自本地 Parquet 数据仓库(基于 RQSDK 格式)的真实 A 股市场数据来计算这些统计量。我们将重点分析长三角地区的重要上市公司,包括宁波港 (601018) 和宁波银行 (002142),这些公司在区域经济发展中具有重要地位。
数学原理:协方差与相关系数的公理化定义
在量化投资中,理解资产间的互动逻辑是风险管理的基石。
1. 协方差 (Covariance) 衡量两个随机变量 \(R_i\) 和 \(R_j\) 如何共同变化。其样本形式为:
\[ \text{Cov}(R_i, R_j) = \frac{1}{n-1} \sum_{t=1}^{n} (R_{i,t} - \bar{R}_i)(R_{j,t} - \bar{R}_j) \]
- \(\text{Cov} > 0\): 资产趋向于同步运行。
- \(\text{Cov} < 0\): 资产趋向于对冲运行。
2. 皮尔逊相关系数 (Pearson Correlation) 通过标准差对协方差进行归一化,将其约束在 \([-1, 1]\):
\[ \rho_{ij} = \frac{\text{Cov}(R_i, R_j)}{\sigma_i \sigma_j} \]
这一指标消除了量纲(如股价绝对值)的影响,使我们能够比较不同长三角上市公司收益率的线性联动。低历史相关不等于未来必然分散风险;结论还取决于样本期、频率、缺失处理和相关结构的稳定性。
import pandas as pd # 用pandas读取四只A股前复权日行情并按真实交易日对齐
import numpy as np # 用NumPy支持收益率矩阵的二阶统计与数值核验
from pathlib import Path # 提供路径对象接口用于必要的数据文件存在性扩展检查
# 从同一前复权日行情表下推证券代码条件,避免先加载全市场记录
ningbo_port = pd.read_hdf( # 读取宁波港日行情,证券代码在where条件中唯一确定
f'{DATA_ROOT}/stock/stock_price_pre_adjusted.h5', # 复用首块DATA_ROOT定位A股前复权HDF5仓库
where="order_book_id='601018.XSHG'" # 只保留上交所宁波港记录,后续价格列命名为公司名
).reset_index().rename(columns={'date': 'trade_date', 'vol': 'volume'}) # 恢复存储索引并统一日期、成交量字段名以便四表连接
ningbo_bank = pd.read_hdf( # 读取宁波银行日行情,保持与宁波港相同字段schema
f'{DATA_ROOT}/stock/stock_price_pre_adjusted.h5', # 使用同一前复权价格源,保证复权口径可比较
where="order_book_id='002142.XSHE'" # 只保留深交所宁波银行记录,避免证券混入
).reset_index().rename(columns={'date': 'trade_date', 'vol': 'volume'}) # 恢复日期索引并规范字段名以支持按trade_date连接
hengrui = pd.read_hdf( # 读取江苏恒瑞医药的真实前复权行情
f'{DATA_ROOT}/stock/stock_price_pre_adjusted.h5', # 与宁波两股共享同一前复权日行情文件
where="order_book_id='600276.XSHG'" # 按恒瑞医药证券代码下推筛选
).reset_index().rename(columns={'date': 'trade_date', 'vol': 'volume'}) # 将恒瑞医药存储索引恢复为连接键并统一字段名
saic_motor = pd.read_hdf( # 读取上海上汽集团的真实前复权行情
f'{DATA_ROOT}/stock/stock_price_pre_adjusted.h5', # 继续使用相同复权口径的本地日行情文件
where="order_book_id='600104.XSHG'" # 按上汽集团证券代码下推筛选
).reset_index().rename(columns={'date': 'trade_date', 'vol': 'volume'}) # 将上汽集团日期恢复为普通连接键并统一成交量字段名# 提取收盘价并按交易日期对齐
def prepare_close_price(stock_price_df, stock_name): # 将任一单股行情约束为交易日键和命名收盘价列,供后续外连接
"""返回保留交易日期、并以证券名标识收盘价的两列表。""" # 明确输出字段合同,不在函数内改变日期样本
selected_close_df = stock_price_df[['trade_date', 'close']].copy() # 复制日期与收盘价以隔离后续改名
selected_close_df.rename(columns={'close': stock_name}, inplace=True) # 用公司名称标识价格列
return selected_close_df # 返回可按交易日期连接的统一结果# 合并所有股票的收盘价数据
price_data = prepare_close_price(ningbo_port, '宁波港') # 提取宁波港收盘价作为基准DataFrame
price_data = price_data.merge( # 把第二条价格序列按交易日并入基准表,形成双证券宽表
prepare_close_price(ningbo_bank, '宁波银行'), # 右表提供命名收盘价列,非共同交易日将在对应证券列产生缺失
on='trade_date', how='outer' # 以交易日期为连接键,采用外连接保留全部日期
) # 首次外连接形成宁波港/宁波银行日期并集,非共同日期暂留缺失
price_data = price_data.merge( # 第三次外连接把价格宽表扩为三列,同时延展交易日期并集
prepare_close_price(hengrui, '恒瑞医药'), # 合并江苏恒瑞医药收盘价
on='trade_date', how='outer' # 以trade_date外连接,保留任一三股出现的交易日期
) # 加入恒瑞医药后仍保留三股日期并集,待末端统一完整案例筛选
price_data = price_data.merge( # 把上汽集团收盘价加入三列宽表形成四公司样本
prepare_close_price(saic_motor, '上汽集团'), # 合并上海上汽集团收盘价
on='trade_date', how='outer' # 再取trade_date并集,随后由完整案例策略统一去除缺失行
) # 加入上汽集团形成四股宽表,每个公司列对应一条收盘价序列
# 按日期排序,并把样本限定为四只股票都有收盘价的共同交易日
price_data = price_data.sort_values('trade_date').dropna() # 外连接产生的非共同日期含NA;整行剔除后才可同日比较收益
# 把已排序且四股共同可观测的trade_date绑定为唯一时间轴
price_data.set_index('trade_date', inplace=True) # 用唯一升序共同交易日作为收益计算的时间轴
price_data.head() # 展示共同样本最早五个交易日的四公司收盘价| 宁波港 | 宁波银行 | 恒瑞医药 | 上汽集团 | |
|---|---|---|---|---|
| trade_date | ||||
| 2010-09-28 | 2.5505 | 4.9686 | 5.6668 | 9.2520 |
| 2010-09-29 | 2.4790 | 4.9515 | 5.4634 | 9.0176 |
| 2010-09-30 | 2.5362 | 5.1224 | 5.5743 | 9.1866 |
| 2010-10-08 | 2.5648 | 5.2463 | 5.7137 | 9.2629 |
| 2010-10-11 | 2.6576 | 5.4769 | 5.3595 | 9.3938 |
现在我们计算价格的百分比变化,这代表了每日收益率。在金融学中,收益率 \(R_t\) 通常定义为:
\[ R_t = \frac{P_t - P_{t-1}}{P_{t-1}} = \frac{P_t}{P_{t-1}} - 1 \]
其中 \(P_t\) 是第 \(t\) 期的价格。这种计算方法在时间序列分析中是一个基本操作。
returns = price_data.pct_change(fill_method=None) # 对四公司共同交易日收盘价计算相邻日简单收益,首行保留结构性NaN
returns.tail() # 展示共同样本末五个交易日的四公司简单收益率| 宁波港 | 宁波银行 | 恒瑞医药 | 上汽集团 | |
|---|---|---|---|---|
| trade_date | ||||
| 2025-12-25 | 0.005450 | -0.002115 | 0.002776 | 0.000000 |
| 2025-12-26 | -0.005420 | -0.010950 | -0.005537 | 0.003238 |
| 2025-12-29 | -0.005450 | 0.002143 | -0.009008 | -0.007747 |
| 2025-12-30 | -0.005479 | 0.004277 | -0.005454 | -0.001301 |
| 2025-12-31 | 0.000000 | -0.003194 | -0.010136 | -0.008469 |
Series 的 corr 方法计算两个序列之间重叠的、非 NA 的、按索引对齐的值的相关性。类似地,cov 计算协方差。让我们计算宁波港与宁波银行之间的相关性和协方差:
# 计算宁波港和宁波银行收益率的相关性
corr_nb = returns['宁波港'].corr(returns['宁波银行']) # 计算宁波港与宁波银行日收益率的Pearson相关系数
print(f'宁波港与宁波银行的相关系数: {corr_nb:.4f}') # 报告共同日收益样本的Pearson相关系数并保留四位小数
# 计算宁波港和宁波银行收益率的协方差
cov_nb = returns['宁波港'].cov(returns['宁波银行']) # 计算宁波港与宁波银行日收益率的样本协方差
print(f'宁波港与宁波银行的协方差: {cov_nb:.6f}') # 报告同一样本的日收益协方差,单位为收益率平方宁波港与宁波银行的相关系数: 0.3139
宁波港与宁波银行的协方差: 0.000124实证分析:宁波港与宁波银行的联动解读
这里的 corr_nb 只描述当前样本、当前频率和当前缺失处理下两只股票收益的线性相关。即使样本相关为正,也不能仅凭这一统计量识别实体经济、资金流动性或任何共同冲击的因果机制;若要比较分散化效果,还需报告样本区间、估计不确定性、市场与行业暴露以及相关结构的稳定性。
DataFrame 的 corr 和 cov 方法分别返回一个完整的相关性矩阵或协方差矩阵,形式为 DataFrame。这个矩阵在现代投资组合理论中具有至关重要的地位,因为它是计算投资组合方差的基础。
投资组合方差的数学原理:
对于一个包含 \(n\) 个资产的投资组合,权重向量为 \(w = (w_1, w_2, ..., w_n)^T\),投资组合收益率为:
\[ R_p = \sum_{i=1}^{n} w_i R_i = w^T R \]
投资组合方差为:
\[ \sigma_p^2 = \text{Var}(R_p) = \text{Var}\left(\sum_{i=1}^{n} w_i R_i\right) = \sum_{i=1}^{n}\sum_{j=1}^{n} w_i w_j \text{Cov}(R_i, R_j) = w^T \Sigma w \]
其中 \(\Sigma\) 是 \(n \times n\) 的协方差矩阵。这正是我们需要计算协方差矩阵的原因!
# 计算所有股票的相关性矩阵
corr_matrix = returns.corr() # 计算所有股票收益率两两之间的Pearson相关系数矩阵
print('相关性矩阵:') # 标明下方4×4对称表按宁波港、宁波银行、恒瑞、上汽列序比较
print(corr_matrix) # 展示4×4的相关系数矩阵
# 计算所有股票的协方差矩阵
cov_matrix = returns.cov() # 计算所有股票收益率两两之间的样本协方差矩阵
print('\n协方差矩阵:') # 前加空行后打印协方差矩阵标题
print(cov_matrix) # 展示4×4的协方差矩阵相关性矩阵:
宁波港 宁波银行 恒瑞医药 上汽集团
宁波港 1.000000 0.313899 0.195654 0.285257
宁波银行 0.313899 1.000000 0.237451 0.396586
恒瑞医药 0.195654 0.237451 1.000000 0.262261
上汽集团 0.285257 0.396586 0.262261 1.000000
协方差矩阵:
宁波港 宁波银行 恒瑞医药 上汽集团
宁波港 0.000353 0.000124 0.000077 0.000111
宁波银行 0.000124 0.000442 0.000105 0.000173
恒瑞医药 0.000077 0.000105 0.000439 0.000114
上汽集团 0.000111 0.000173 0.000114 0.000428金融工程应用:相关性矩阵的多重意义
- 分散化边界: 若 \(\rho \to 0\),根据 Markowitz 理论,投资组合的方差将显著低于资产方差的加权平均。
- 因子暴露诊断: 较高的样本相关可提示研究者进一步检查行业、市场与宏观因子暴露,但不能单独证明共同原因。
- 配对研究初筛: 历史相关只能用于提出候选配对;正式策略还需协整或误差修正检验、交易成本、稳定性与样本外评估。
本地样本展示了四家长三角公司在所选区间内的收益相关结构。该结果是描述性证据,可用于提出分散化假设,但尚未控制行业、市场 beta、样本选择或结构变化,不能直接证明某个交易策略有效。
使用 DataFrame 的 corrwith 方法,可以计算一个 DataFrame 的各列与另一个 Series 的成对相关性。例如,下面以恒瑞医药为参照:
# 计算所有股票与恒瑞医药的相关性
corr_with_hengrui = returns.corrwith(returns['恒瑞医药']) # 按重叠非缺失日期计算各公司与恒瑞医药的 Pearson 相关
print('各股票与恒瑞医药的相关性:') # 标明参照资产和统计对象
print(corr_with_hengrui) # 展示样本相关系数,不外推为未来关系各股票与恒瑞医药的相关性:
宁波港 0.195654
宁波银行 0.237451
恒瑞医药 1.000000
上汽集团 0.262261
dtype: float645.4.2 唯一值、值计数和成员资格 (Unique Values, Value Counts, and Membership)
另一类相关方法用于提取关于一维Series中所含值的信息。
char_series = pd.Series(['c', 'a', 'd', 'a', 'a', 'b', 'b', 'c', 'c']) # 创建包含重复字符的Series用于演示去重和计数unique给你一个Series中唯一值的数组:
uniques = char_series.unique() # 按首次出现顺序提取c/a/d/b四个字符类别,不附带频次
uniques # 展示去重结果保持c、a、d、b的首次出现次序而非排序次序array(['c', 'a', 'd', 'b'], dtype=object)value_counts计算一个包含值频率的Series,并按降序排序:
char_series.value_counts() # 按降序统计a/b/c/d在九项字符观测中的出现次数c 3
a 3
b 2
d 1
Name: count, dtype: int64isin执行一个向量化的集合成员资格检查:
mask = char_series.isin(['b', 'c']) # 判断值是否在给定集合中
mask # 展示九项字符中属于b或c的位置为True,供下一步按同索引筛选0 True
1 False
2 False
3 False
4 False
5 True
6 True
7 True
8 True
dtype: boolchar_series[mask] # 用布尔掩码过滤出值为'b'或'c'的元素0 c
5 b
6 b
7 c
8 c
dtype: object与isin相关的是Index.get_indexer方法,它给你一个从可能非唯一值的数组到另一个唯一值数组的索引数组:
labels_to_match = pd.Series(['c', 'a', 'b', 'b', 'c', 'a']) # 创建待匹配的标签Series
unique_labels = pd.Series(['c', 'b', 'a']) # 创建唯一标签的参照Series
indices = pd.Index(unique_labels).get_indexer(labels_to_match) # 在unique_labels中查找每个待匹配标签的位置索引
indices # 展示c/a/b/b/c/a分别映射到参照序列位置0/2/1/1/0/2array([0, 2, 1, 1, 0, 2])表 5.9 提供了这些方法的参考。
| 方法 | 描述 |
|---|---|
isin |
计算一个布尔数组,指示每个值是否包含在传递的值序列中 |
get_indexer |
为一个数组中的每个值计算到另一个唯一值数组的整数索引;有助于数据对齐和连接类型的操作 |
unique |
计算Series中的唯一值数组,按观察到的顺序返回 |
value_counts |
返回一个Series,其索引为唯一值,值为频率,按计数降序排列 |
要在DataFrame中的多个相关列上计算直方图(例如处理问卷调查数据):
survey_df = pd.DataFrame({'问题1': [1, 3, 4, 3, 4], # 创建包含3道问卷题的5个受访者打分的DataFrame
'问题2': [2, 3, 1, 2, 3], # 问题2的5个受访者分数
'问题3': [1, 5, 2, 4, 4]}) # 问题3的5个受访者分数
survey_df # 展示五名受访者对三道题的1—5分原始响应矩阵| 问题1 | 问题2 | 问题3 | |
|---|---|---|---|
| 0 | 1 | 2 | 1 |
| 1 | 3 | 3 | 5 |
| 2 | 4 | 1 | 2 |
| 3 | 3 | 2 | 4 |
| 4 | 4 | 3 | 4 |
要计算所有列的值计数,可对每列调用对象自身的 value_counts 方法:
result = survey_df.apply(lambda column: column.value_counts()).fillna(0) # 对每列分别统计各值的出现次数,缺失组合填0
result # 展示每道题在1—5五种评分上的频数,缺少的评分组合以0填充| 问题1 | 问题2 | 问题3 | |
|---|---|---|---|
| 1 | 1.0 | 1.0 | 1.0 |
| 2 | 0.0 | 2.0 | 1.0 |
| 3 | 2.0 | 2.0 | 0.0 |
| 4 | 2.0 | 0.0 | 2.0 |
| 5 | 0.0 | 0.0 | 1.0 |
还有一个DataFrame.value_counts方法,但它将DataFrame的每一行视为一个元组来计算每个不同行的出现次数。
tuple_df = pd.DataFrame({'a': [1, 1, 1, 2, 2], 'b': [0, 0, 1, 0, 0]}) # 创建含重复行组合的两列DataFrame
tuple_df.value_counts() # 统计(a,b)两列联合取值组合的重复频数a b
1 0 2
2 0 2
1 1 1
Name: count, dtype: int645.5 习题
5.5.1 基础习题
习题 5.1: Series 创建与索引
下面给定一组只用于练习Series操作的固定常量(标签沿用城市名,数值不作为官方2023年GDP统计):
- 北京:4.38
- 上海:4.72
- 天津:1.67
- 重庆:3.01
- 创建这个Series,并使用城市名作为索引
- 添加一个名为’description’的属性,值为’2023年GDP’
- 将Series转换为字典
- 筛选出GDP大于3万亿元的城市
解答:
代码清单 列表 5.1 给出 Series 属性、字典转换与条件筛选的完整实现。
import pandas as pd # 用pandas把四城GDP字典转换为带城市标签的Series
# (a) 创建Series
gdp_data = { # 定义四个直辖市2023年GDP数据字典
'北京': 4.38, # 北京GDP(4.38万亿元)
'上海': 4.72, # 上海GDP(4.72万亿元)
'天津': 1.67, # 天津GDP(1.67万亿元)
'重庆': 3.01 # 重庆GDP(3.01万亿元)
} # 完成题设城市与 GDP 常量字典
gdp_series = pd.Series(gdp_data) # 用字典创建Series,键为城市索引、值为GDP
print('(a) 创建的Series:') # 标明输出以四个直辖市为索引、GDP万亿元为值
print(gdp_series) # 展示四个直辖市的GDP数据
# (b) 添加description属性
gdp_series.description = '2023年GDP' # 为Series添加自定义属性description
print(f'\n(b) description属性: {gdp_series.description}') # 验证属性设置是否成功
# (c) 转换为字典
gdp_dict = gdp_series.to_dict() # 将Series转换为Python字典
print(f'\n(c) 转换为字典: {gdp_dict}') # 展示转换后的字典
# (d) 筛选GDP大于3的城市
large_cities = gdp_series[gdp_series > 3.0] # 用布尔索引筛选GDP超过3万亿的城市
print('\n(d) GDP大于3万亿元的城市:') # 标明布尔条件严格大于3.0万亿元并保留城市标签
print(large_cities) # 展示筛选出的城市及GDP(a) 创建的Series:
北京 4.38
上海 4.72
天津 1.67
重庆 3.01
dtype: float64
(b) description属性: 2023年GDP
(c) 转换为字典: {'北京': 4.38, '上海': 4.72, '天津': 1.67, '重庆': 3.01}
(d) GDP大于3万亿元的城市:
北京 4.38
上海 4.72
重庆 3.01
dtype: float64习题 5.2: DataFrame 基础操作
下面给定一张只用于练习DataFrame计算的固定输入表。题中GDP与人口数值不作为当前官方统计,重点是列运算、分组和单位换算:
| 省份 | 年份 | GDP(万亿元) | 人口(万人) |
|---|---|---|---|
| 广东 | 2020 | 11.07 | 12601 |
| 广东 | 2021 | 12.44 | 12684 |
| 浙江 | 2020 | 6.46 | 6456 |
| 浙江 | 2021 | 7.35 | 6540 |
- 创建这个DataFrame
- 计算人均GDP(单位:万元)
- 按年份分组,计算平均GDP
- 按省份分组,计算GDP总和
解答:
代码清单 列表 5.2 在同一真实量纲下完成人均值与分组汇总。
import pandas as pd # 用pandas构造两省两年的面板表并执行分组聚合
# (a) 创建DataFrame
data = { # 定义省份经济属性数据字典
'省份': ['广东', '广东', '浙江', '浙江'], # 两省各两年数据
'年份': [2020, 2021, 2020, 2021], # 对应的年份
'GDP': [11.07, 12.44, 6.46, 7.35], # GDP(万亿元)
'人口': [12601, 12684, 6456, 6540] # 人口(万人)
} # 完成题设省份面板数据字典
df = pd.DataFrame(data) # 用字典构建省份GDP与人口的DataFrame
print('(a) 创建的DataFrame:') # 标明输出是两省×两年的四行题设原始表
print(df) # 展示完整的DataFrame
# (b) 计算人均GDP(注意单位转换:GDP万亿元=10000亿元,人口万人)
df['人均GDP_万元'] = (df['GDP'] * 10000) / df['人口'] # GDP万亿×10000÷人口万人,得人均GDP(万元)
print('\n(b) 添加人均GDP列:') # 标明新增列按万亿元与万人换算为万元/人
print(df) # 展示含新列的DataFrame
# (c) 按年份分组
avg_gdp_by_year = df.groupby('年份')['GDP'].mean() # 按年份分组后计算平均GDP
print('\n(c) 按年份分组的平均GDP:') # 引出每年两个省份的GDP算术平均值,单位仍为万亿元
print(avg_gdp_by_year) # 展示各年份的平均GDP
# (d) 按省份分组
total_gdp_by_province = df.groupby('省份')['GDP'].sum() # 按省份分组后计算GDP总和
print('\n(d) 按省份分组的GDP总和:') # 引出每省跨2020—2021两期相加的题设GDP总量
print(total_gdp_by_province) # 展示各省份两年GDP之和(a) 创建的DataFrame:
省份 年份 GDP 人口
0 广东 2020 11.07 12601
1 广东 2021 12.44 12684
2 浙江 2020 6.46 6456
3 浙江 2021 7.35 6540
(b) 添加人均GDP列:
省份 年份 GDP 人口 人均GDP_万元
0 广东 2020 11.07 12601 8.785017
1 广东 2021 12.44 12684 9.807632
2 浙江 2020 6.46 6456 10.006196
3 浙江 2021 7.35 6540 11.238532
(c) 按年份分组的平均GDP:
年份
2020 8.765
2021 9.895
Name: GDP, dtype: float64
(d) 按省份分组的GDP总和:
省份
广东 23.51
浙江 13.81
Name: GDP, dtype: float64习题 5.3: 数据对齐与缺失值
考虑以下两个Series:
s1 = pd.Series([10, 20, 30], index=['a', 'b', 'c']) # 构造索引为a/b/c的左侧题设序列
s2 = pd.Series([5, 15, 25, 35], index=['a', 'c', 'd', 'e']) # 构造与s1仅部分重叠的右侧题设序列- 计算 s1 + s2,并解释结果
- 使用 fill_value=0 参数计算加法
- 对 s1 进行重建索引,使其包含 s2 的所有索引,缺失值用前向填充(ffill)
解答:
代码清单 列表 5.3 对照默认对齐、填充值与重建索引三种语义。
import pandas as pd # 用pandas读取两只A股行情并构造日、月、年频收益序列
import numpy as np # 用NumPy执行年化缩放和数值一致性核验
s1 = pd.Series([10, 20, 30], index=['a', 'b', 'c']) # 创建含三个元素的Series(索引a/b/c)
s2 = pd.Series([5, 15, 25, 35], index=['a', 'c', 'd', 'e']) # 创建含四个元素的Series(索引a/c/d/e,与s1部分重叠)
# (a) 直接相加
result_a = s1 + s2 # 直接相加,索引不匹配处自动产生 NaN
print('(a) s1 + s2:') # 标明输出按a—e标签并集对齐,非共同标签将产生NaN
print(result_a) # 展示对齐相加的结果
print('说明:索引不匹配的值为NaN,这是pandas的数据对齐特性') # 解释b仅在s1、d/e仅在s2导致相加结果缺失
# (b) 使用fill_value
result_b = s1.add(s2, fill_value=0) # 缺失值填0后再相加,避免NaN传播
print('\n(b) 使用fill_value=0:') # 标明仅单侧缺失的标签先以0补齐再相加
print(result_b) # 展示填充后的加法结果
# (c) 重建索引并前向填充
result_c = s1.reindex(s2.index, method='ffill') # 以s2的a/c/d/e标签顺序重建s1,并沿标签顺序前向填充
print('\n(c) s1重建索引(ffill):') # 标明输出使用s2标签集合且d/e承接s1在c处的最近值
print(result_c) # 展示前向填充后的结果(a) s1 + s2:
a 15.0
b NaN
c 45.0
d NaN
e NaN
dtype: float64
说明:索引不匹配的值为NaN,这是pandas的数据对齐特性
(b) 使用fill_value=0:
a 15.0
b 20.0
c 45.0
d 25.0
e 35.0
dtype: float64
(c) s1重建索引(ffill):
a 10
c 30
d 30
e 30
dtype: int645.5.2 进阶习题
习题 5.4: 索引与选择
给定以下DataFrame:
import numpy as np # 使用NumPy构造带连续整数值的索引练习表
# 将连续整数重塑为4×4矩阵,并绑定省市行标签与业务列标签
data = pd.DataFrame(
np.arange(16).reshape((4, 4)),
index=['北京', '上海', '广东', '浙江'],
columns=['one', 'two', 'three', 'four']
) # 题设值与位置一一对应,供后续比较loc标签边界和iloc位置边界- 选择 ‘two’ 列
- 选择行索引为 ‘上海’ 和 ‘浙江’ 的行
- 选择 ‘上海’ 和 ‘浙江’ 行的 ‘one’ 和 ‘three’ 列(使用 loc)
- 选择前两行和前两列(使用 iloc)
- 选择 ‘three’ 列值大于 5 的行
- 解释为什么
data[data['three'] > 5]['one'] = 0存在链式索引风险,并用单次loc完成原表赋值
解答:
代码清单 列表 5.4 集中展示标签选择、位置选择与布尔筛选。
import pandas as pd # 用pandas演示省市行标签、业务列标签与loc/iloc选择
import numpy as np # 用NumPy生成0—15连续整数作为可追踪的4×4表值
data = pd.DataFrame( # 构造四省市×one—four的4×4索引练习表
np.arange(16).reshape((4, 4)), # 用连续整数0-15填充4行4列
index=['北京', '上海', '广东', '浙江'], # 行标签顺序用于区分loc标签选择与iloc轴位置选择
columns=['one', 'two', 'three', 'four'] # 列标签定义四项选择练习的业务键
) # 形成四省市×四业务列的带标签矩阵
print('原始DataFrame:') # 先展示完整行列标签与0—15位置映射作为各小题基准
print(data) # 展示原始DataFrame
# (a) 选择'two'列
col_two = data['two'] # 通过列名选取two列,返回Series
print('\n(a) two列:') # 标明输出保留四个省市索引并只含two列值
print(col_two) # 展示two列各省市的值
# (b) 选择特定行
rows = data.loc[['上海', '浙江']] # loc按给定标签顺序返回两行,并保留one—four全部四列
print('\n(b) 上海和浙江行:') # 标明按标签且按给定顺序返回上海、浙江两行
print(rows) # 展示选取的行
# (c) 使用loc选择特定行和列
selected = data.loc[['上海', '浙江'], ['one', 'three']] # 以两个省市行键和两个业务列键得到2×2交叉子表
print('\n(c) 上海和浙江的one和three列:') # 标明loc同时限定2个行键与2个列键,结果为2×2
print(selected) # 结果应为2×2,行列顺序均与传给loc的标签列表一致
# (d) 使用iloc选择前两行前两列
subset = data.iloc[:2, :2] # 用iloc按位置选取前2行前2列
print('\n(d) 前两行前两列:') # 标明iloc按轴位置得到北京/上海与one/two交叉子表
print(subset) # 位置半开边界:2保留轴0/1的前两项,对应北京、上海与one、two的2×2子表
# (e) 条件选择
filtered = data[data['three'] > 5] # 布尔索引筛选three列值大于5的行
print('\n(e) three列大于5的行:') # 标明行筛选键来自three列且保留命中行全部四列
print(filtered) # 展示满足条件的行原始DataFrame:
one two three four
北京 0 1 2 3
上海 4 5 6 7
广东 8 9 10 11
浙江 12 13 14 15
(a) two列:
北京     1
上海     5
广东     9
浙江    13
Name: two, dtype: int64
(b) 上海和浙江行:
one two three four
上海 4 5 6 7
浙江 12 13 14 15
(c) 上海和浙江的one和three列:
one three
上海 4 6
浙江 12 14
(d) 前两行前两列:
one two
北京 0 1
上海 4 5
(e) three列大于5的行:
one two three four
上海 4 5 6 7
广东 8 9 10 11
浙江 12 13 14 15代码清单 列表 5.5 随后用单次 .loc 修正链式索引风险。
assignment_mask = data['three'] > 5  # 先构造与原表索引对齐的布尔条件以便复核命中行
data.loc[assignment_mask, 'one'] = 0  # 用一次loc同时指定行和列,避免对临时对象赋值
assert data.loc[assignment_mask, 'one'].eq(0).all()  # 验证所有目标行已经在原DataFrame中更新
链式写法先执行布尔筛选,再对中间对象取列;该中间对象究竟共享数据还是独立复制不应成为赋值逻辑的前提,并可能触发警告或产生未回写结果。单次 loc 把行条件与目标列放在同一操作中,赋值对象和意图都明确。
习题 5.5: 函数应用与映射
给定以下包含学生成绩的DataFrame:
# 固定三科成绩题设,使逐行与逐列统计可以按同一输入复核
grades = pd.DataFrame({
    '姓名': ['张三', '李四', '王五', '赵六'],
    '数学': [85, 92, 78, 88],
    '英语': [90, 85, 92, 80],
    '物理': [82, 88, 85, 90]
}) # 四行学生记录共享三门课程字段,后续行聚合与列聚合使用同一原始样本- 计算每个学生的总分和平均分
- 计算每门课的平均分和标准差
- 将分数转换为等级(A: 90-100, B: 80-89, C: 70-79, D: <70)
- 找出每门课的最高分学生
- 按总分降序排序并生成并列名次,同时核对结果索引、总分 dtype 和缺失值数量
解答:
代码清单 列表 5.6 构造成绩表并完成核心汇总与等级转换。
import pandas as pd                                         # 用pandas按姓名行记录计算成绩列统计、等级与排名
import numpy as np                                          # 用NumPy支持排名结果的dtype和缺失数量核验

grades = pd.DataFrame({                                     # 构造四名学生的数学、英语、物理三科整数成绩表
    '姓名': ['张三', '李四', '王五', '赵六'],  # 四名学生姓名
    '数学': [85, 92, 78, 88],  # 数学成绩
    '英语': [90, 85, 92, 80],  # 英语成绩
    '物理': [82, 88, 85, 90]  # 物理成绩
})  # 形成四名学生×姓名及三科分数的原始schema
print('原始成绩表:')  # 展示尚未添加总分、均分和等级列的四名学生原始成绩
print(grades)  # 展示原始成绩数据
原始成绩表:
姓名 数学 英语 物理
0 张三 85 90 82
1 李四 92 85 88
2 王五 78 92 85
3 赵六 88 80 90(a) 计算总分和平均分
grades['总分'] = grades[['数学', '英语', '物理']].sum(axis=1)  # 求每个学生三科总分
grades['平均分'] = grades[['数学', '英语', '物理']].mean(axis=1)  # 求每个学生三科平均分
print('\n(a) 添加总分和平均分:')                                    # 标明每行对数学、英语、物理三科聚合后的派生列
print(grades)  # 展示含新列的完整成绩表
(a) 添加总分和平均分:
   姓名  数学  英语  物理   总分        平均分
0  张三  85  90  82  257  85.666667
1  李四  92  85  88  265  88.333333
2  王五  78  92  85  255  85.000000
3  赵六  88  80  90  258  86.000000
(b) 计算每门课的统计量
subject_stats = grades[['数学', '英语', '物理']].agg(['mean', 'std'])  # 对三科同时计算均值和标准差
print('\n(b) 各科平均分和标准差:')                                   # 标明每列以四名学生为样本计算均值与样本标准差
print(subject_stats)  # 展示各科统计指标
(b) 各科平均分和标准差:
             数学         英语     物理
mean  85.750000  86.750000  86.25
std    5.909033   5.377422   3.50
(c) 转换为等级
def score_to_grade(score):                                  # 按从高到低的互斥下界映射单项分数,保证边界90、80、70只落入一档
    if score >= 90:  # 先判定90分下界,使A档覆盖题设最高区间
        return 'A'                                          # 最高区间保留为优秀档,且先匹配可阻止继续落入较低档
    elif score >= 80:                                       # 未达90分时继续判断80分下界
        return 'B'                                          # 未进优秀档但达到80分的观测归入良好档
    elif score >= 70:                                       # 未达80分时继续判断70分下界
        return 'C'                                          # 达到及格下界但不足80分的观测归入中间档
    else:                                                   # 前三项下界均未命中时,剩余低于70分观测进入D档
        return 'D'                                          # 低于70分的其余观测映射为等级D

# 对所有成绩列应用转换
grade_columns = ['数学', '英语', '物理']                          # 定义需要转换等级的三个科目列名
for col in grade_columns:  # 按数学、英语、物理列名逐列生成对应等级列
    grades[f'{col}_等级'] = grades[col].apply(score_to_grade)  # 将分数映射为A/B/C/D等级

print('\n(c) 转换为等级:')                                       # 标明输出保留原始分数并新增三项A—D分类列
print(grades)  # 展示含等级列的完整成绩表
(c) 转换为等级:
   姓名  数学  英语  物理   总分        平均分 数学_等级 英语_等级 物理_等级
0  张三  85  90  82  257  85.666667     B     A     B
1  李四  92  85  88  265  88.333333     A     B     B
2  王五  78  92  85  255  85.000000     C     A     B
3  赵六  88  80  90  258  86.000000     B     B     A
(d) 找出每门课的最高分学生
print('\n(d) 各科最高分学生:')                                     # 引出每科最高分及首个达到该分数的学生姓名
for subject in grade_columns:  # 依次以数学、英语、物理列为分组目标查找最高分
    max_score = grades[subject].max()                       # 取该科目的最高分
    top_student = grades[grades[subject] == max_score]['姓名'].values[0]  # 找到最高分对应的学生姓名
    print(f'{subject}: {top_student} ({max_score}分)')  # 输出该科目最高分的学生信息
(d) 各科最高分学生:
数学: 李四 (92分)
英语: 王五 (92分)
物理: 赵六 (90分)
(e) 排序、排名与结果核验
代码清单 列表 5.7 单独核验并列名次、索引和 schema。
grades['总分名次'] = grades['总分'].rank(method='min', ascending=False).astype('int64')  # 对并列总分赋相同最优整数名次
ranked_grades = grades.sort_values(['总分', '姓名'], ascending=[False, True]).reset_index(drop=True)  # 先按总分降序再按姓名稳定排序
assert ranked_grades.index.equals(pd.RangeIndex(len(ranked_grades)))  # 验证重排后索引是连续且唯一的位置索引
assert pd.api.types.is_integer_dtype(ranked_grades['总分'])  # 验证整数成绩求和后仍保持整数dtype
assert ranked_grades[['姓名', '总分', '总分名次']].isna().sum().sum() == 0  # 核对核心展示字段没有静默缺失
print(ranked_grades[['姓名', '总分', '总分名次']])  # 展示已通过索引、dtype与缺失审计的排名表
姓名 总分 总分名次
0 李四 265 1
1 赵六 258 2
2 张三 257 3
3 王五 255 45.5.3 应用习题
习题 5.6: 股票收益率分析
假设你已经获取了宁波港(601018)和宁波银行(002142)的股票价格数据。
- 计算两只股票的日收益率、月收益率和年收益率
- 计算两只股票的波动率(标准差)
- 绘制两只股票起点为 1 的财富指数曲线,并报告期末累计简单收益(财富指数减 1)
- 计算并比较夏普比率(假设无风险利率为3%)
- 计算样本协方差与 Pearson 相关系数,并说明描述性结果不能识别因果机制
解答:
代码清单 列表 5.8 先冻结两只长三角股票的共同价格样本。
import pandas as pd                                         # 用pandas将两只股票按唯一共同交易日连接并重采样收益频率
import numpy as np                                          # 用NumPy完成年化波动率缩放及财富路径数值验证
from pathlib import Path                                    # 保留路径对象接口供本地行情文件诊断使用

# 从同一前复权日行情文件分别下推两只证券代码条件
ningbo_port = pd.read_hdf(                              # 读取宁波港全样本日行情,尚未改变日期或缺失口径
    f'{DATA_ROOT}/stock/stock_price_pre_adjusted.h5',  # 复用本章跨平台DATA_ROOT定位前复权HDF5文件
    where="order_book_id='601018.XSHG'"         # 只保留上交所宁波港,作为左侧价格序列
).reset_index().rename(columns={'date': 'trade_date', 'vol': 'volume'})  # 将宁波港存储索引恢复为日期列并统一字段schema
ningbo_bank = pd.read_hdf(                              # 读取宁波银行全样本日行情,保持相同复权口径
    f'{DATA_ROOT}/stock/stock_price_pre_adjusted.h5',  # 与宁波港共享数据源,避免混用复权方式
    where="order_book_id='002142.XSHE'"         # 只保留深交所宁波银行,作为右侧价格序列
).reset_index().rename(columns={'date': 'trade_date', 'vol': 'volume'})  # 将宁波银行存储索引恢复为日期列并统一字段schema

# 准备数据
def prepare_stock_data(stock_price_df, stock_name):  # 定义把单只股票行情统一为日期和命名价格列的函数
    """准备可按交易日期连接的股票收盘价表。"""  # 记录函数输出的数据合同与连接用途
    selected_stock_df = stock_price_df[['trade_date', 'close']].copy()  # 隔离后续类型转换与改名操作
    selected_stock_df.rename(columns={'close': stock_name}, inplace=True)  # 用公司名称标识收盘价列
    selected_stock_df['trade_date'] = pd.to_datetime(selected_stock_df['trade_date'], format='%Y%m%d')  # 统一交易日期类型
    return selected_stock_df  # 返回两列标准化行情表供后续按日期连接

port_data = prepare_stock_data(ningbo_port, '宁波港')  # 提取宁波港的日期和收盘价
bank_data = prepare_stock_data(ningbo_bank, '宁波银行')  # 提取宁波银行的日期和收盘价

# 合并数据
price_data = port_data.merge(bank_data, on='trade_date', how='inner', validate='one_to_one')  # 只保留两只股票共同且唯一的真实交易日期
price_data = price_data.sort_values('trade_date')  # 按共同交易日期升序排列以定义相邻收益区间
price_data.set_index('trade_date', inplace=True)            # 将日期设为行索引
assert price_data.index.is_monotonic_increasing and price_data.index.is_unique  # 核对收益计算所需的日期顺序与唯一性
assert price_data.notna().all().all()  # 验证共同日期价格表没有会污染收益计算的缺失值
(a) 计算收益率
代码清单 列表 5.9 核验日、月、年收益的端点和频率口径。
daily_returns = price_data.pct_change(fill_method=None)  # 按共同真实交易日期计算相邻日简单收益且不自动填充
monthly_prices = price_data.resample('ME').last()  # 选取每个日历月最后一条真实交易日收盘价
monthly_returns = monthly_prices.pct_change(fill_method=None)  # 用相邻月末真实价格计算月度简单收益
annual_prices = price_data.resample('YE').last()  # 选取每个日历年最后一条真实交易日收盘价
annual_returns = annual_prices.pct_change(fill_method=None)  # 用相邻年末真实价格计算年度简单收益
monthly_last_dates = price_data.index.to_series().resample('ME').max()  # 记录每个月实际使用的最后交易日期
annual_last_dates = price_data.index.to_series().resample('YE').max()  # 记录每个年度实际使用的最后交易日期
assert daily_returns.iloc[0].isna().all()  # 验证首期因没有前一交易日价格而结构性缺失
assert daily_returns.iloc[1:].notna().all().all()  # 核对后续共同日期收益没有额外缺失
print(f'(a) 日收益样本: {price_data.index.min().date()} 至 {price_data.index.max().date()}')  # 报告日频计算的真实起止日
print(f'首个结构性NaN行数: {daily_returns.isna().all(axis=1).sum()}')  # 审计首期缺失没有被误填为零收益
print('\n月末标签与实际最后交易日(末3期):')  # 提示月末标签不一定是中国市场实际交易日
print(monthly_last_dates.tail(3).rename('实际最后交易日'))  # 展示月频端点所对应的真实观测日期
print('\n年末标签与实际最后交易日:')  # 提示年度收益使用每年最后一条真实收盘价
print(annual_last_dates.rename('实际最后交易日'))  # 展示所有年度端点以便审计跨年区间
print('\n年度简单收益率(首个可比较跨年区间起):')  # 明确首年度因无前一年端点而没有年度收益
print(annual_returns.dropna(how='all'))  # 完整报告两只股票所有可计算年度收益
(a) 日收益样本: 2010-09-28 至 2025-12-31
首个结构性NaN行数: 1
月末标签与实际最后交易日(末3期):
trade_date
2025-10-31 2025-10-31
2025-11-30 2025-11-28
2025-12-31 2025-12-31
Freq: ME, Name: 实际最后交易日, dtype: datetime64[ns]
年末标签与实际最后交易日:
trade_date
2010-12-31 2010-12-31
2011-12-31 2011-12-30
2012-12-31 2012-12-31
2013-12-31 2013-12-31
2014-12-31 2014-12-31
2015-12-31 2015-12-31
2016-12-31 2016-12-30
2017-12-31 2017-12-29
2018-12-31 2018-12-28
2019-12-31 2019-12-31
2020-12-31 2020-12-31
2021-12-31 2021-12-31
2022-12-31 2022-12-30
2023-12-31 2023-12-29
2024-12-31 2024-12-31
2025-12-31 2025-12-31
Freq: YE-DEC, Name: 实际最后交易日, dtype: datetime64[ns]
年度简单收益率(首个可比较跨年区间起):
宁波港 宁波银行
trade_date
2011-12-31 -0.226738 -0.247872
2012-12-31 0.104142 0.188560
2013-12-31 -0.014082 -0.109403
2014-12-31 0.956137 0.782578
2015-12-31 0.788628 0.209492
2016-12-31 -0.370080 0.105265
2017-12-31 0.062245 0.417128
2018-12-31 -0.361463 -0.066792
2019-12-31 0.160469 0.765924
2020-12-31 0.057696 0.275426
2021-12-31 0.033839 0.148903
2022-12-31 -0.077010 -0.139374
2023-12-31 0.019542 -0.367490
2024-12-31 0.109124 0.243226
2025-12-31 -0.022854 0.206807(b) 计算波动率(年化)
daily_vol_port = daily_returns['宁波港'].std()                 # 计算宁波港日收益率标准差
daily_vol_bank = daily_returns['宁波银行'].std()                # 计算宁波银行日收益率标准差

# 年化波动率(假设252个交易日)
annual_vol_port = daily_vol_port * np.sqrt(252)             # 按252交易日假设缩放宁波港日收益标准差
annual_vol_bank = daily_vol_bank * np.sqrt(252)             # 按相同252日口径缩放宁波银行日收益标准差

print(f'\n(b) 年化波动率:')                                      # 标明两项数值由共同日收益样本标准差乘√252得到
print(f'宁波港: {annual_vol_port:.4f} ({annual_vol_port*100:.2f}%)')  # 展示宁波港年化波动率
print(f'宁波银行: {annual_vol_bank:.4f} ({annual_vol_bank*100:.2f}%)')  # 报告共同日收益样本标准差按√252缩放后的无量纲年化值及百分比
(b) 年化波动率:
宁波港: 0.2983 (29.83%)
宁波银行: 0.3338 (33.38%)
(c) 绘制财富指数并报告累计简单收益
代码清单 列表 5.10 从共同样本构造财富指数和期末累计收益。
wealth_index = (1.0 + daily_returns.fillna(0.0)).cumprod()  # 仅把已审计的结构性首期NaN设为0,使财富指数从1起步
cumulative_simple_returns = wealth_index - 1.0  # 按定义用财富指数减1得到累计简单收益率
normalized_prices = price_data.divide(price_data.iloc[0])  # 直接用价格相对首日归一化构造独立核验路径
pd.testing.assert_frame_equal(wealth_index, normalized_prices)  # 核对收益复合与价格归一化得到相同财富指数
print('\n(c) 期末财富指数:')  # 明确数值1代表初始财富而不是零累计收益
print(wealth_index.iloc[-1])  # 完整报告两只股票的期末相对财富
print('\n(c) 期末累计简单收益率(财富指数减1):')  # 明确累计收益和财富指数相差1
print(cumulative_simple_returns.iloc[-1])  # 报告两只股票从样本首日至末日的净累计收益
(c) 期末财富指数:
宁波港 1.423250
宁波银行 5.653504
Name: 2025-12-31 00:00:00, dtype: float64
(c) 期末累计简单收益率(财富指数减1):
宁波港 0.423250
宁波银行 4.653504
Name: 2025-12-31 00:00:00, dtype: float64图 图 5.2 展示本节讨论对象的可视化结果,读图时应结合正文给出的口径与限制。
import matplotlib.pyplot as plt # 使用Matplotlib实际绘制两只股票的财富指数曲线
plt.rcParams['font.sans-serif'] = ['Source Han Serif SC'] # 使用项目统一中文字体显示公司名称
plt.rcParams['axes.unicode_minus'] = False # 保证坐标轴负号在中文字体环境中正确显示
wealth_index.plot(figsize=(10, 5), linewidth=1.2) # 一次绘制DataFrame的两列并保留各自图例
plt.axhline(1.0, color='#8E9EAA', linestyle='--', linewidth=1) # 标出初始财富基准便于识别盈亏区间
plt.title('宁波港与宁波银行财富指数') # 图题明确曲线不是累计收益率本身
plt.xlabel('交易日期') # 横轴使用共同真实交易日期
plt.ylabel('财富指数(起点=1)') # 纵轴明确数值口径和起点
plt.legend(title='股票') # 图例沿用两列证券标签,使每条财富曲线可追溯到对应价格序列
plt.tight_layout() # 避免日期、轴标题和图例相互遮挡
plt.show() # 呈现共同交易日上的宁波港、宁波银行财富指数及起点1参考线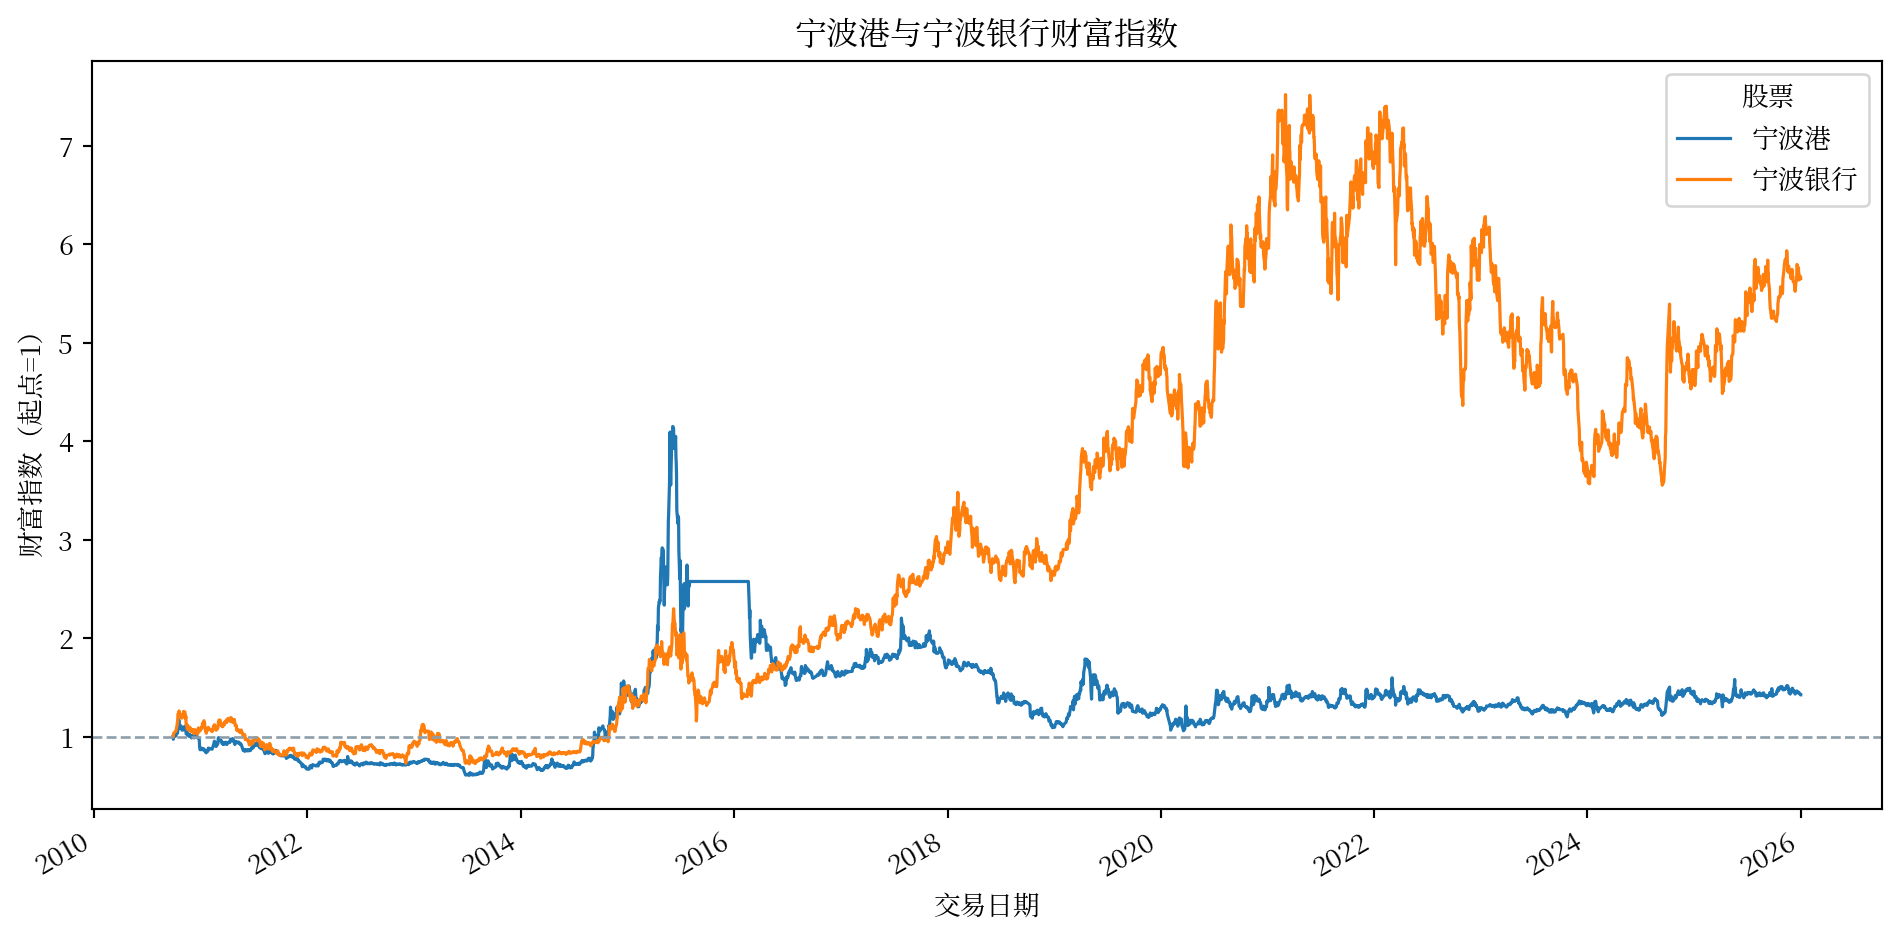
(d) 计算夏普比率
# 年化收益率
annual_return_port = daily_returns['宁波港'].mean() * 252 # 日均收益率×252得宁波港年化收益率
annual_return_bank = daily_returns['宁波银行'].mean() * 252 # 日均收益率×252得宁波银行年化收益率
# 无风险利率(年化3%)
risk_free_rate = 0.03 # 假定年化无风险利率为3%
# 夏普比率 = (年化收益率 - 无风险利率) / 年化波动率
sharpe_port = (annual_return_port - risk_free_rate) / annual_vol_port # 计算宁波港夏普比率
sharpe_bank = (annual_return_bank - risk_free_rate) / annual_vol_bank # 计算宁波银行夏普比率
print(f'\n(d) 夏普比率:') # 标明分子按年化日均收益减题设3%无风险利率计算
print(f'宁波港: {sharpe_port:.4f}') # 展示宁波港夏普比率
print(f'宁波银行: {sharpe_bank:.4f}') # 报告同一共同样本、252日年化和3%无风险利率口径下的无量纲比率
print('\n说明:夏普比率衡量每承担一单位风险所获得的超额收益,') # 说明本题分子采用题设3%年化无风险利率后的超额收益
print('数值越高表示风险调整后的收益越好。') # 提醒该排序只描述当前共同样本与年化口径,不构成因果判断
(d) 夏普比率:
宁波港: 0.1284
宁波银行: 0.4290
说明:夏普比率衡量每承担一单位风险所获得的超额收益,
数值越高表示风险调整后的收益越好。(e) 计算样本协方差与 Pearson 相关系数
代码清单 列表 5.11 把共同有效收益期作为二阶统计量的统一样本。
valid_daily_returns = daily_returns.dropna(how='any') # 只在两只股票收益均可观察的共同区间估计二阶统计量
sample_covariance = valid_daily_returns['宁波港'].cov(valid_daily_returns['宁波银行']) # 用n-1分母估计两只股票日收益样本协方差
sample_correlation = valid_daily_returns['宁波港'].corr(valid_daily_returns['宁波银行']) # 估计当前样本的Pearson线性相关系数
assert np.isclose(sample_covariance, valid_daily_returns.cov().loc['宁波港', '宁波银行']) # 用矩阵接口独立核对协方差口径
assert np.isclose(sample_correlation, valid_daily_returns.corr().loc['宁波港', '宁波银行']) # 用相关矩阵独立核对Pearson结果
print(f'(e) 样本协方差: {sample_covariance:.8f}') # 报告统一日频与共同日期下的协方差估计
print(f'(e) Pearson相关系数: {sample_correlation:.4f}') # 报告当前样本的线性相关描述量(e) 样本协方差: 0.00012403
(e) Pearson相关系数: 0.3139这些数值只适用于本题的数据版本、共同交易日期、日频收益和样本区间。它们可以描述线性联动并提出进一步研究假设,但没有控制市场、行业或宏观因素,也没有识别实体经济或资金流动性的因果机制。
理论升华:夏普比率的边界与局限
夏普比率(Sharpe Ratio)是马科维茨框架下衡量风险调整后收益的“黄金准则”:
\[ \text{Sharpe Ratio} = \frac{E[R_p] - R_f}{\sigma_p} \]
经济内涵: - 性价比指标:它描述了单位总风险(Total Risk)所交换到的超额收益。 - 不可机械评级:夏普比率没有跨市场、跨频率和跨样本通用的投资等级阈值;比较前必须统一无风险利率、年化方式、样本期、交易成本和收益分布口径。
批判性思考: 1. 定义与额外假设:夏普比率的计算只使用超额收益均值和标准差,并不要求收益正态。正态或椭圆分布等额外假设会影响它能否充分代表投资者偏好、不同组合的排序以及常规统计推断;面对尖峰厚尾、偏度和极端回撤,只报告均值与方差可能遗漏重要风险。 2. 不区分性质:它对上行波动(盈利)和下行波动(亏损)一视同仁,但在实际心理感受上,投资者更倾向于使用只关注下行风险的索提诺比率(Sortino Ratio)。
习题 5.7: 数据对齐在投资组合中的应用
假设你有以下三个资产的历史收益率数据:
asset_A = pd.Series([0.02, 0.03, -0.01, 0.04, 0.02], # 构造从1月1日起的资产A题设收益
index=pd.date_range('2023-01-01', periods=5)) # 为资产A设置五个连续日期标签
asset_B = pd.Series([0.01, 0.02, 0.03, -0.02, 0.01], # 构造比资产A晚一天开始的资产B题设收益
index=pd.date_range('2023-01-02', periods=5)) # 用错位日期制造需要明确处理的缺失
asset_C = pd.Series([0.015, 0.025, 0.01, 0.03, 0.02], # 构造与资产A同日起点的资产C题设收益
index=pd.date_range('2023-01-01', periods=5)) # 为资产C设置五个连续日期标签构建一个固定等权重投资组合(权重各为 1/3)。本题采用完整案例政策:只有三项收益都可观察的日期才进入组合计算;任一资产缺失的日期整体排除,不把缺失收益当成 0,也不在剩余资产之间动态再归一。计算:
- 投资组合的每日收益率序列
- 投资组合的累计收益
- 投资组合的波动率
- 如果每个资产的初始投资为10000元,计算期末组合价值
解答:
代码清单 列表 5.12 按日期对齐三项资产收益并计算组合结果。
import pandas as pd # 用pandas按日期并集对齐三项题设资产收益Series
import numpy as np # 用NumPy核验固定等权权重和年化波动率计算
# 构造三项资产错开一天的日期索引,以显式制造自动对齐缺失
asset_A = pd.Series([0.02, 0.03, -0.01, 0.04, 0.02], # A资产作为1月1日起的日期对齐基准
index=pd.date_range('2023-01-01', periods=5)) # 从2023-01-01起的连续5个交易日
asset_B = pd.Series([0.01, 0.02, 0.03, -0.02, 0.01], # B资产晚一天起始,用于制造首日结构性缺失
index=pd.date_range('2023-01-02', periods=5)) # 从01-02起,与A/C错开1天
asset_C = pd.Series([0.015, 0.025, 0.01, 0.03, 0.02], # C资产复用A的日期范围,形成完整对照列
index=pd.date_range('2023-01-01', periods=5)) # 与A相同的日期索引
# 合并为DataFrame(演示pandas的数据对齐功能)
returns_df = pd.DataFrame({ # 将三个资产收益率合并为DataFrame
'Asset_A': asset_A, # A列在1月1日至5日有观测、1月6日缺失
'Asset_B': asset_B, # B列在1月1日缺失、1月2日至6日有观测
'Asset_C': asset_C # C列与A共享索引,用于区分标签对齐和数值内容
}) # 日期不一致时pandas自动按索引对齐,缺失处为NaN
print('收益率数据(注意pandas自动对齐了不同的索引):') # 提示输出对齐后的收益率表
print(returns_df) # 展示日期并集以及Asset_A/C首日、Asset_B末日错位产生的NaN收益率数据(注意pandas自动对齐了不同的索引):
Asset_A Asset_B Asset_C
2023-01-01 0.02 NaN 0.015
2023-01-02 0.03 0.01 0.025
2023-01-03 -0.01 0.02 0.010
2023-01-04 0.04 0.03 0.030
2023-01-05 0.02 -0.02 0.020
2023-01-06 NaN 0.01 NaN(a) 计算等权重投资组合的每日收益率
complete_returns_df = returns_df.dropna(how='any') # 仅保留三项资产收益都可观察的共同日期
weights = pd.Series(1 / 3, index=complete_returns_df.columns) # 用列标签绑定固定等权权重,防止位置错配
assert np.isclose(weights.sum(), 1.0) # 验证每个有效日期使用的目标权重总和为1
portfolio_returns = complete_returns_df.mul(weights, axis='columns').sum(axis='columns', min_count=3) # 三项齐全时才计算加权收益
assert portfolio_returns.notna().all() # 验证进入后续统计的组合收益没有隐藏缺失值
print('\n(a) 投资组合每日收益率:') # 提示输出组合每日收益率
print(portfolio_returns) # 展示仅三项收益齐全日期上的固定等权组合日收益
(a) 投资组合每日收益率:
2023-01-02 0.021667
2023-01-03 0.006667
2023-01-04 0.033333
2023-01-05 0.006667
Freq: D, dtype: float64(b) 计算累计收益
cumulative_returns = (1 + portfolio_returns).cumprod() - 1 # 复利累计收益率=(1+r1)*(1+r2)*...-1
print('\n(b) 投资组合累计收益率:') # 提示输出累计收益率
print(cumulative_returns) # 展示完整案例日期上按(1+r)逐期复合的净累计收益
(b) 投资组合累计收益率:
2023-01-02 0.021667
2023-01-03 0.028478
2023-01-04 0.062760
2023-01-05 0.069845
Freq: D, dtype: float64(c) 计算波动率(年化,假设252个交易日)
volatility = portfolio_returns.std() * np.sqrt(252) # 日收益率标准差×√252年化为年波动率
print(f'\n(c) 投资组合年化波动率: {volatility:.4f} ({volatility*100:.2f}%)') # 格式化输出年化波动率(小数和百分比)
(c) 投资组合年化波动率: 0.2054 (20.54%)(d) 计算期末组合价值
initial_investment_cny = 10000 # 约定每项资产的期初投入为1万元
total_initial_cny = initial_investment_cny * len(weights) # 按三项资产计算组合期初总额
final_value_cny = total_initial_cny * (1 + cumulative_returns.iloc[-1]) # 用共同日期上的组合累计收益计算期末价值
print(f'\n(d) 期末组合价值:') # 提示输出期末价值信息
print(f'初始投资总额: {total_initial_cny:,.2f} 元') # 输出三项资产的期初总投入
print(f'期末价值: {final_value_cny:,.2f} 元') # 输出完整案例政策下的期末组合市值
print(f'绝对收益: {final_value_cny - total_initial_cny:,.2f} 元') # 输出同一口径的绝对盈亏
print(f'收益率: {cumulative_returns.iloc[-1]*100:.2f}%') # 取最终累计收益率并以百分比输出
(d) 期末组合价值:
初始投资总额: 30,000.00 元
期末价值: 32,095.36 元
绝对收益: 2,095.36 元
收益率: 6.98%核心机制:数据对齐在资产组合中的数学逻辑
习题 5.7 展示了 Pandas 数据对齐机制,也说明“自动对齐”并不会替研究者决定缺失资产的经济含义。
- 非同步交易处理:不同资产(如 A 股、港股、美股)有不同的交易日历。Pandas 在合并
Series时会自动寻找日期的并集。 - 显式缺失政策:
sum()默认会跳过NaN;若直接对固定权重结果求和,缺失资产会被静默当成零贡献。本题先dropna(),明确排除不完整日期。若业务选择现金持有或动态再归一,必须另写权重与现金收益逻辑。 - 内联 Join 操作:这相当于在底层执行了一个逻辑上的“外连接”(Outer Join),确保了分析的时间维度完整性。
5.5.4 可选进阶方法阅读:事件研究设计(不纳入本章考核)
事件研究需要回归、统计检验与信息时点先修,超出 Pandas 入门的核心目标。本节只给出研究设计清单,不指定任意交易日、不运行事件回归,也不对任何公司作事件影响或因果判断。
若后续使用本地长三角上市公司开展真实事件研究,应依次完成:
- 从交易所公告或本地可追溯披露表取得公告首次公开的北京时间,并保留公告标识、来源和抓取快照;不得用“第 150 个交易日”替代事件日。
- 按公告发生在开盘前、交易时段或收盘后,把信息映射到首个可交易日,并预先规定事件窗口与无重叠筛选规则。
- 在事件窗口之前选择估计期,用市场模型 \(R_{i,t}=\alpha_i+\beta_iR_{m,t}+\varepsilon_{i,t}\) 估计正常收益;若改用 CAPM,则个股和市场两侧都必须扣除同口径无风险收益。
- 报告异常收益与 CAR 时,说明参数估计误差、事件期协方差、截面相关和事件聚类如何进入标准误;简单的 \(\hat\sigma_\varepsilon\sqrt{L}\) 只可在明确的独立同方差近似下使用。
- 把显著性结果表述为“在给定模型与假设下,对零异常收益假设的证据”,而不是“公告导致股价变化”。因果解释还需要排除同期消息、选择偏差和其他混杂因素。
方法检查答案:一项合格设计至少能回答“消息何时首次可得、何时可交易、基准是什么、估计期是否先于事件、标准误允许什么相关结构、结论是描述还是因果”六个问题。任一问题没有可追溯答案,就应停止在方法设计阶段,不输出公司层面的显著或不显著结论。
5.6 结论
下一章进入数据清洗与准备:在本章索引对齐和缺失值传播的基础上,系统处理缺失、重复、异常值、类型转换和标准化。数据读写已经在第 4 章讲授,不再作为下一章主题。
通过本章的学习和习题练习,你应该已经掌握了:
- pandas核心数据结构:Series和DataFrame的创建、索引和基本操作
- 数据对齐机制:pandas如何通过索引自动对齐数据,这是其强大之处
- 数据选择与过滤:使用.loc、.iloc和布尔索引灵活地访问数据
- 数据运算:包括算术运算、函数应用和自定义映射
- 数据汇总与描述统计:特别是相关性和协方差在金融中的应用
- 实战能力:通过习题,你已经能够处理真实的金融数据,进行基本的投资分析
这些技能将为你后续学习更高级的数据分析和机器学习技术打下坚实的基础。